SCPC 2021 1차 예선에 참가했습니다 (1/3)

TechnologyProgrammingCompetitive Programming

1차 예선 — 800/800

올해는 예년보다 문제들이 쉬워진 느낌이었습니다. 다섯 문제를 전부 풀었습니다.

제 풀이를 공유합니다.

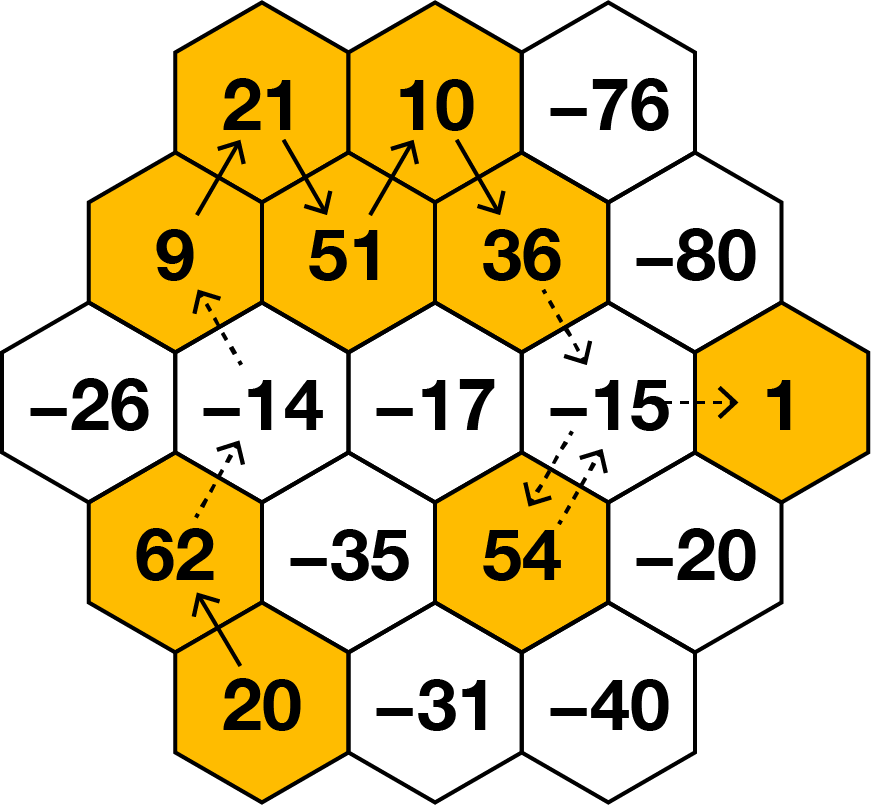
1차 1번 – 친구들

사람이 N≤100 000N \leq 100\,000명 있습니다.

번호 ii인 사람은 수 DiD_i를 갖고 있는데, i+Di≤Ni + D_i \leq N라면 ii번 사람과 i+Dii + D_i번 사람은 친구입니다. 또, 친구의 친구는 친구입니다.

이 때, ‘극대 그룹’의 수를 찾아야 합니다.


친구 관계를 그래프로 생각해 봅시다. ‘친구의 친구가 친구‘라는 말을 잘 생각해 보면, 어떤 연결 요소 안의 모든 사람들은 서로 친구가 됩니다.

따라서 DFS/BFS 여러 번을 통해 연결 요소의 수를 세 주면 문제의 답이 됩니다. 또는 DSUdisjoint set union를 사용해도 됩니다. DFS/BFS를 사용하면 O(N)\mathcal{O}\left(N\right)만에 해결할 수 있습니다.

저는 DSU를 사용해서 풀었습니다.

#include <bits/stdc++.h>

using namespace std;
using ll = long long;
using ld = long double;
using pii = pair<int, int>;

/* [t] [c] [s] */

int dsu[100001];

int find(int u) {
    return dsu[u] == u ? u : (dsu[u] = find(dsu[u]));
}

void merge(int u, int v) {
    u = find(u), v = find(v);
    if (u != v) dsu[v] = u;
}

void solve() {
    int n;
    cin >> n;

    iota(dsu + 1, dsu + 1 + n, 1);

    for (int i = 1; i <= n; i++) {
        int x;
        cin >> x;
        if (i + x > n) continue;
        merge(i, i + x);
    }

    set<int> s;
    for (int i = 1; i <= n; i++) s.emplace(find(i));
    cout << s.size() << endl;
}

int main() {
    cin.tie(nullptr), cout.tie(nullptr), ios::sync_with_stdio(false);

#ifdef _SHIFTPSH
    freopen("_run/in.txt", "r", stdin), freopen("_run/out.txt", "w", stdout);
#endif

    int t;
    cin >> t;
    for (int _ = 1; _ <= t; _++) {
        cout << "Case #" << _ << endl;
        solve();
    }

    return 0;
}

DSU를 만들 때 std::iota라는 좋은 함수를 사용하면 쉽고 빠르게 초기화할 수 있습니다. STL에 이런 함수가 있다는 게 좀 의외일까요?

1차 2번 – 이진수

길이가 n≤50 000n \leq 50\,000인 비트 문자열 aa가 있고, 같은 길이의 비트 문자열 bb를 다음과 같이 정의합니다. ∨\vee는 OR 연산입니다.

bi=(ai−t∨ai+t)b_i = \left(a_{i-t} \vee a_{i+t}\right)

bb가 주어지면, 사전순으로 제일 앞서는 aa를 구해야 합니다.


약간 헤멜 수 있는 문제였던 것 같습니다. 일단 두 가지 사실을 기반으로 생각해봅시다.

  • bib_i가 켜져 있다면, ai−ta_{i-t} 또는 ai+ta_{i+t}가 켜져 있어야 합니다.

  • aia_i가 켜져 있다면, bi−tb_{i-t}와 bi+tb_{i+t}가 모두 켜져 있어야 합니다.

이제 bib_i를 왼쪽부터 보면서, 켜져 있으면서 아직 ai−ta_{i-t}와 ai+ta_{i+t} 모두가 꺼져 있는 bib_i들에 대해, 그리디하게 aa의 비트들을 켜 줍니다.

  • 오른쪽(ai+ta_{i+t}) 비트를 켤 수 있으면 켜 줍니다. 오른쪽 비트를 켤 수 있으려면, bi+2tb_{i+2t}가 존재하지 않거나 켜져 있어야 합니다. 이는 사전 순으로 가장 먼저 오는 aa를 구성하기 위함입니다.

  • 오른쪽 비트를 켤 수 없다면 왼쪽(ai−ta_{i-t}) 비트를 켜 줍니다.

생각해 보면 모든 bib_i에 대해 둘 중 하나 이상을 켤 수 있는 경우만 입력으로 주어진다는 사실을 알 수 있습니다. 이를 그대로 구현해 주면 됩니다. O(n)\mathcal{O}\left(n\right)만에 해결할 수 있습니다.

#include <bits/stdc++.h>

using namespace std;
using ll = long long;
using ld = long double;
using pii = pair<int, int>;

/* [t] [c] [s] */

void solve() {
    int n, t;
    cin >> n >> t;

    string b;
    cin >> b;

    vector<int> a(n);
    for (int i = 0; i < n; i++) {
        if (b[i] == '0') continue;
        int l = i - t, r = i + t;
        if ((l >= 0 && a[l]) || (r < n && a[r])) continue;

        int ll = l - t, rr = r + t;
        if (r < n) {
            if (rr >= n || b[rr] == '1') {
                a[r] = 1;
                continue;
            }
        }
        if (l >= 0) {
            if (ll < 0 || b[ll] == '1') {
                a[l] = 1;
                continue;
            }
        }
    }
    for (int i = 0; i < n; i++) cout << a[i];
    cout << endl;
}

int main() {
    cin.tie(nullptr), cout.tie(nullptr), ios::sync_with_stdio(false);

#ifdef _SHIFTPSH
    freopen("_run/in.txt", "r", stdin), freopen("_run/out.txt", "w", stdout);
#endif

    int t;
    cin >> t;
    for (int _ = 1; _ <= t; _++) {
        cout << "Case #" << _ << endl;
        solve();
    }

    return 0;
}

1차 3번 – No Cycle

정점 N≤500N \leq 500개, 간선 M+KM+K개의 그래프가 있습니다. M+KM+K의 간선 중 M≤2 000M \leq 2\,000개는 방향이 있고, K≤2 000K \leq 2\,000개는 방향이 정해지지 않았습니다.

이 때 KK개의 간선들의 방향을 잘 정해서, 사이클이 없는 그래프를 구성하고 싶습니다. 방향이 정해진 MM개의 간선들만 있는 경우에는 사이클이 없는 상태입니다.

답은 KK글자의 비트 문자열입니다. 방향이 없는 ii번째 간선의 입력이 u\textcolor{#ff3b57}{u} v\textcolor{#ffb717}{v}로 주어졌을 때, u→v\textcolor{#ff3b57}{u} \rightarrow\textcolor{#ffb717}{v}로 방향을 정했다면 00, v→u\textcolor{#ffb717}{v} \rightarrow \textcolor{#ff3b57}{u}로 방향을 정했다면 11입니다. 이 때 사전 순으로 가장 앞서는 비트 문자열을 출력해야 합니다.


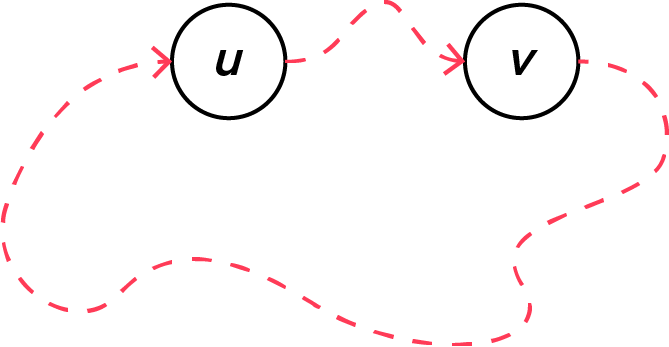
사이클이 없는 방향 그래프에서, 임의의 정점 u\textcolor{#ff3b57}{u}와 v\textcolor{#ffb717}{v}를 고르고 그 정점을 잇는 간선을 추가한다고 생각해 봅시다. u→v\textcolor{#ff3b57}{u} \rightarrow\textcolor{#ffb717}{v}로 정할 수도 있고 v→u\textcolor{#ffb717}{v} \rightarrow \textcolor{#ff3b57}{u}로 정할 수도 있습니다. 두 경우 모두가 사이클을 만드는 경우가 있을까요?
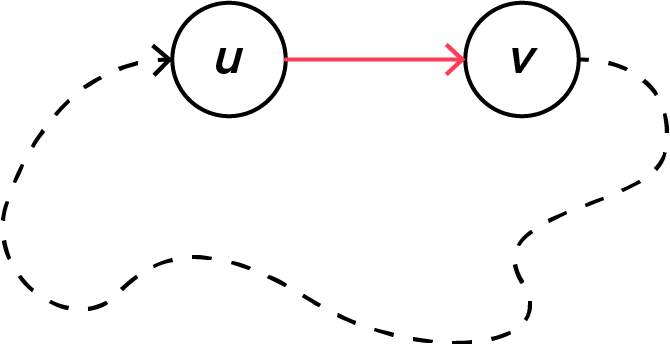
u→v\textcolor{#ff3b57}{u} \rightarrow\textcolor{#ffb717}{v}라는 간선을 추가했을 때 사이클이 생긴다는 것은, v→u\textcolor{#ffb717}{v} \rightarrow \textcolor{#ff3b57}{u}로 가는 경로가 이미 존재한다는 사실과 동치입니다.

따라서 u→v\textcolor{#ff3b57}{u} \rightarrow\textcolor{#ffb717}{v}도 사이클을 만들고 v→u\textcolor{#ffb717}{v} \rightarrow \textcolor{#ff3b57}{u}도 사이클을 만든다면, 각각 v→u\textcolor{#ffb717}{v} \rightarrow \textcolor{#ff3b57}{u}라는 경로와 u→v\textcolor{#ff3b57}{u} \rightarrow\textcolor{#ffb717}{v}라는 경로 모두가 이미 존재해야 됩니다.

하지만 그런 두 개의 경로가 이미 존재한다면, 그 두 개의 경로만으로 사이클을 만들 수 있습니다. 이는 우리가 처음에 한 가정 — 사이클이 없는 방향 그래프 — 에 모순됩니다. 따라서 u→v\textcolor{#ff3b57}{u} \rightarrow\textcolor{#ffb717}{v}와 v→u\textcolor{#ffb717}{v} \rightarrow \textcolor{#ff3b57}{u} 중 적어도 하나는 새로운 사이클을 만들지 않는다는 사실을 알 수 있습니다.

그러므로 이미 사이클이 없는 방향 그래프라면, 간선들을 무한정 추가해줄 수 있습니다. 그래프의 정점과 간선의 수가 작기 때문에, 간선을 추가해줄 때마다 사이클이 생기는지 생기지 않는지 확인하면서 간선을 하나씩 추가해나갈 수 있습니다.

사전 순으로 가장 앞서는 비트 문자열을 구성해야 하므로, 우선 u→v\textcolor{#ff3b57}{u} \rightarrow\textcolor{#ffb717}{v}를 추가한 뒤 사이클이 안 생긴다면 그대로 가져갑니다. 사이클이 생긴다면 위의 증명을 통해 v→u\textcolor{#ffb717}{v} \rightarrow \textcolor{#ff3b57}{u}를 추가해줄 수 있음이 보장된다는 것을 알 수 있으므로, 그렇게 해 줍니다.

사이클의 존재 여부를 판단하는 방법은 여러 가지가 있습니다. 저는 DFS로 구현했습니다. 그래프가 연결 그래프임은 보장되지 않으므로, 방문하지 않은 모든 정점에서 DFS를 시작해야 함에 유의합니다.

간선을 KK개 추가해 주고, 추가할 때마다 DFS를 한 번 해야 하므로 O(K(N+K+M))\mathcal{O}\left(K\left(N+K+M\right)\right)의 시간이 걸립니다.

#include <bits/stdc++.h>

using namespace std;
using ll = long long;
using ld = long double;
using pii = pair<int, int>;

/* [t] [c] [s] */

bitset<501> root;
int vis[501], ans[2000];

bool dfs(int u, const vector<vector<int>> &graph) {
    // check for cycles
    if (vis[u]) return vis[u] == -1;
    vis[u] = -1;
    for (int v : graph[u]) {
        if (dfs(v, graph)) return true;
    }
    vis[u] = 1;
    return false;
}

void solve() {
    int n, m, k;
    cin >> n >> m >> k;

    root.reset(), root.flip();

    vector<vector<int>> graph(n + 1);

    for (int i = 0; i < m; i++) {
        int u, v;
        cin >> u >> v;
        graph[u].emplace_back(v);
    }
    
    for (int i = 0; i < k; i++) {
        int u, v;
        cin >> u >> v;

        // 0?
        graph[u].emplace_back(v);
        memset(vis, 0, sizeof vis);
        bool flag = true;
        for (int x = 1; x <= n; x++) {
            if (vis[x]) continue;
            if (dfs(x, graph)) {
                flag = false;
                break;
            }
        }
        ans[i] = !flag;
        if (flag) continue;
        
        // 1?
        graph[u].pop_back();
        graph[v].emplace_back(u);
    }

    for (int i = 0; i < k; i++) cout << ans[i];
    cout << endl;
}

int main() {
    cin.tie(nullptr), cout.tie(nullptr), ios::sync_with_stdio(false);

#ifdef _SHIFTPSH
    freopen("_run/in.txt", "r", stdin), freopen("_run/out.txt", "w", stdout);
#endif

    int t;
    cin >> t;
    for (int _ = 1; _ <= t; _++) {
        cout << "Case #" << _ << endl;
        solve();
    }

    return 0;
}

1차 4번 – 예약 시스템

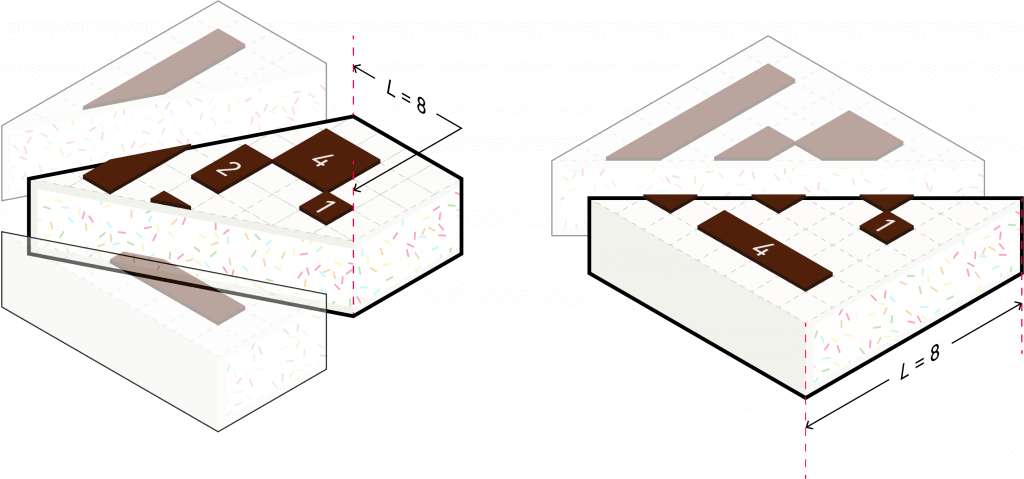
2×m2 \times m개의 방이 있는 호텔이 있습니다. m≤50 000m \leq 50\,000입니다.

n≤20 000n\leq 20\,000개 그룹의 투숙객들이 호텔에 묵으려 합니다. 각 그룹의 크기는 55 이상이고, 한 명이 한 개의 방에 묵습니다.

모든 투숙객들은 스트레스 지수 wiw_i를 갖고 있어서, 인접한 방에 다른 그룹의 투숙객이 있고 그 투숙객의 스트레스 지수가 wjw_j라면, 그 쌍에 대해 wi+wjw_i + w_j만큼의 충돌이 발생합니다. 모든 쌍에 대해 충돌의 합을 최소화하고 싶습니다.

(그냥 이렇게 설명하면 끝나는 문제인데, SCPC 운영진은 디스크립션을 어렵게 쓰는 재주가 있는 걸까요?)


SCPC의 서브태스크는 보통은 만점 풀이와는 무관한 브루트포스 풀이를 요구하는 경향이 있는데, 이 문제는 서브태스크 순서대로 생각해 보면 정해 풀이까지 다다를 수 있는 문제였다고 생각합니다.

문제를 처음 읽으면 어떻게 배치해야 될지 조차 감이 오지 않지만 서브태스크가 그룹 크기가 홀수 또는 짝수인 경우로 나뉘어 있다는 점에서 착안해 아래와 같은 접근을 시작할 수 있었습니다.

서브태스크 1: 그룹이 모두 짝수인 경우

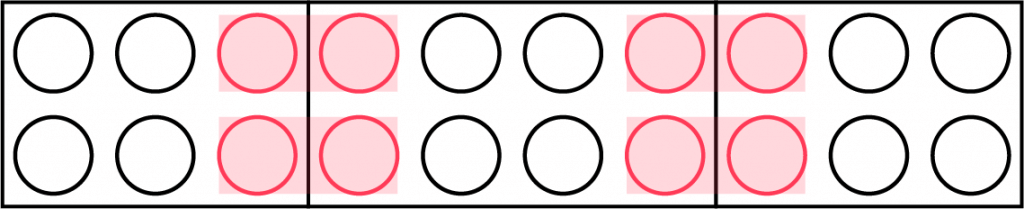
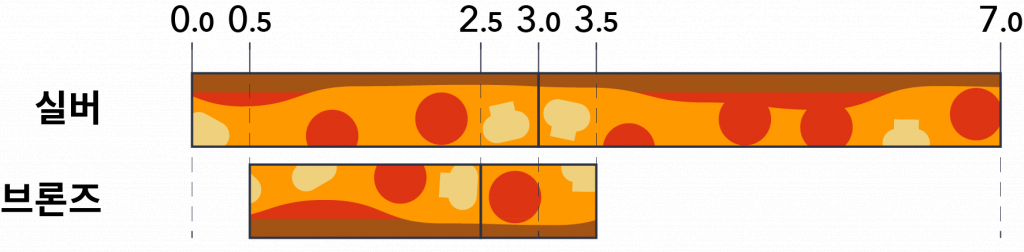
우선 그룹의 크기 lil_i가 모두 짝수일 때의 경우, 최적의 배치가 어떻게 되는지 생각해 봅시다. 다른 그룹과 ‘닿는’ 부분이 최소화되면 좋을 것 같습니다. 그런 배치는 아래 그림과 같이, 2×li22 \times \frac{l_i}{2} 직사각형들을 이어 붙인 경우가 됩니다.

이 때 핑크색으로 칠한 부분에서 충돌이 일어납니다.

그룹의 순서가 정해져 있을 때 충돌의 합을 최소화하려면, 첫 번째 그룹과 마지막 그룹에서는 제일 작은 원소 22개씩을 고르고, 나머지 그룹에서는 제일 작은 원소 44개씩을 고르면 됩니다.

다르게 생각한다면 모든 그룹에서 제일 작은 원소 44개씩을 고른 후, 두 개의 그룹에서만 33번째로 작은 원소와 44번째로 작은 원소 하나씩을 빼 주면 됩니다.

ii번째 그룹에서 jj번째로 작은 원소를 mi,jm_{i,j}라고 합시다. 그러면 모든 그룹을 mi,3+mi,4m_{i,3}+m_{i,4} 순으로 정렬한 후, ∑i(mi,1+mi,2+mi,3+mi+4)\sum_i \left(m_{i,1}+m_{i,2}+m_{i,3}+m_{i+4}\right)에서 mi,3+mi,4m_{i,3}+m_{i,4}가 제일 큰 두 그룹만 빼 주면 정답입니다.

서브태스크 2: 그룹이 모두 홀수인 경우

짝수인 경우와 비슷하게 배치해줄 수 있습니다.
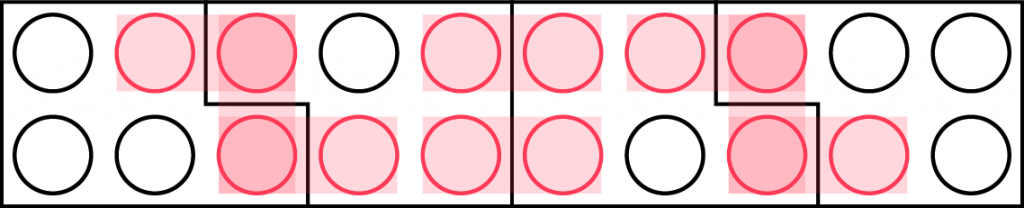
이 경우에는 충돌이 조금 더 많이 생기긴 합니다만, 짝수의 경우와 비슷하게 접근할 수 있습니다.

우선 각 그룹마다 두 번씩 충돌이 일어나는 원소가 하나 있는데, 이를 그 그룹에서 가장 작은 원소로 둡시다. 그러면 모든 그룹에서 제일 작은 원소 44개씩을 고른 후, 두 개의 그룹에서만 33번째로 작은 원소와 44번째로 작은 원소 하나씩을 빼 주면 되는 것은 동일합니다만, 가장 작은 원소는 한 번 더 더해줘야 합니다.

다시 말하면 모든 그룹을 mi,3+mi,4m_{i,3}+m_{i,4} 순으로 정렬한 후, ∑i(2mi,1+mi,2+mi,3+mi+4)\sum_i \left(\textcolor{#ff3b57}{2m_{i,1}}+m_{i,2}+m_{i,3}+m_{i+4}\right)에서 mi,3+mi,4m_{i,3}+m_{i,4}가 제일 큰 두 그룹만 빼 주면 정답입니다.

서브태스크 3: 짝수 그룹과 홀수 그룹이 섞여 있는 경우

위에서의 접근을 바탕으로, 크게는 33가지 경우로 나눠 생각할 수 있습니다.

  • 짝수 그룹과 홀수 그룹이 하나 이상씩 있다면, 맨 왼쪽 그룹과 맨 오른쪽 그룹에 짝수 그룹 하나와 홀수 그룹 하나씩이 있는 경우
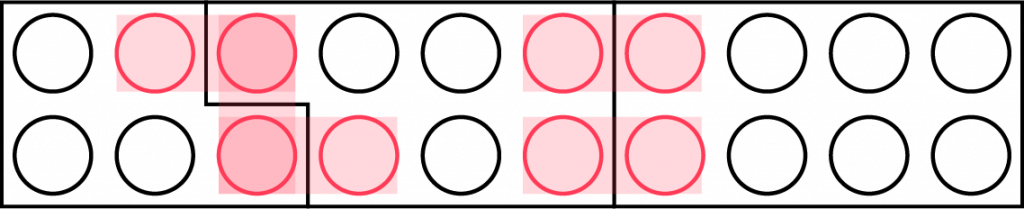
  • 짝수 그룹의 개수가 22개 이상이라면, 맨 왼쪽 그룹과 맨 오른쪽 그룹이 모두 짝수 그룹인 경우

  • 홀수 그룹의 개수가 22개 이상이라면, 맨 왼쪽 그룹과 맨 오른쪽 그룹이 모두 홀수 그룹인 경우

3a: 맨 왼쪽 그룹과 맨 오른쪽 그룹에 짝수 그룹 하나와 홀수 그룹 하나씩이 있는 경우

먼저 홀수 그룹들을 전부 왼쪽에 배치하고, 나머지 짝수 그룹들을 전부 오른쪽에 배치합시다.

짝수 그룹 중 mi,3+mi,4m_{i,3}+m_{i,4}가 가장 큰 그룹 하나와, 홀수 그룹 중 mi,3+mi,4m_{i,3}+m_{i,4}가 가장 큰 그룹 하나를 골라서 빼 주면 됩니다.

3b: 맨 왼쪽 그룹과 맨 오른쪽 그룹이 모두 짝수 그룹인 경우

위의 경우와 비슷합니다. 오른쪽에 있는 짝수 그룹들 중 하나를 빼다가 맨 왼쪽에 붙이면 됩니다.

짝수 그룹 중 mi,3+mi,4m_{i,3}+m_{i,4}가 가장 큰 그룹 두 개를 골라서 빼 주면 됩니다.

3c: 맨 왼쪽 그룹과 맨 오른쪽 그룹이 모두 홀수 그룹인 경우

이 경우는 약간 까다롭습니다.

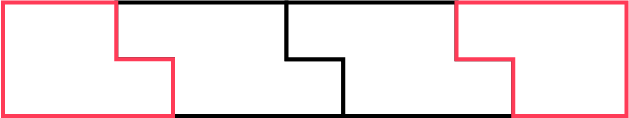
일단 홀수 그룹 두 개를 잘 합치면 직사각형을 만들 수 있다는 점에서 착안해 아래와 같은 배치를 생각할 수 있습니다.
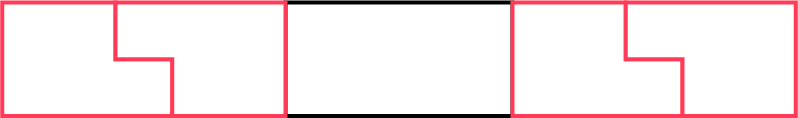
이 경우, 홀수 그룹 중 mi,3+mi,4m_{i,3}+m_{i,4}가 가장 큰 그룹 두 개를 골라서 빼 주면 됩니다.

하지만 이런 경우는 홀수 그룹이 44개 이상인 경우에만 만들 수 있습니다. 홀수 그룹이 22개라면 어쩔 수 없이 아래와 같은 경우로 구성해야 합니다.

이 경우에는, 짝수 그룹들에서 ∑i(2mi,1+2mi,2+mi,3+mi+4)\sum_i \left(\textcolor{#ff3b57}{2m_{i,1}}+\textcolor{#ff3b57}{2m_{i,2}}+m_{i,3}+m_{i+4}\right)를 해 줘야 합니다. 홀수 그룹이 22개인 경우에만 특수하게 처리해줍시다.

모든 경우를 고려한 코드는 아래와 같습니다. 정렬이 필요하기 때문에 O(nlog⁡n)\mathcal{O}\left(n \log n\right)만큼의 시간이 걸립니다. 사실 제일 큰 두 개 그룹만 구해도 상관없기 때문에, 잘 짠다면 O(n)\mathcal{O}\left(n\right)도 가능하지만요.

#include <bits/stdc++.h>

using namespace std;
using ll = long long;
using ld = long double;
using pii = pair<int, int>;

/* [t] [c] [s] */

int a[100000];
pii p[20000];

void solve() {
    int n, m;
    cin >> n >> m;

    ll s = 0, sa = 0;
    ll oc = 0, ec = 0;

    for (int i = 0; i < n; i++) {
        int l;
        cin >> l;
        for (int j = 0; j < l; j++) cin >> a[j];
        sort(a, a + l);
        ((l & 1) ? oc : ec)++;
        p[i].first = a[2] + a[3];
        p[i].second = (l & 1);
        s += (1 + (l & 1)) * a[0] + a[1] + a[2] + a[3];
        sa += 2 * a[0] + (2 - (l & 1)) * a[1] + a[2] + a[3];
    }

    sort(p, p + n, greater<>());

    if (oc && ec) {
        ll coe = 0, coo = 0, cee = 0;

        // coe: o o .. o e .. e e
        int o = 0, e = 0;
        for (int i = 0; i < n; i++) {
            if (!o && p[i].second) {
                coe += p[i].first;
                o++;
            }
            if (!e && !p[i].second) {
                coe += p[i].first;
                e++;
            }
            if (o && e) break;
        }

        // coo: o o .. o e .. e o .. o o
        if (oc >= 2) {
            o = 0;
            for (int i = 0; i < n; i++) {
                if (o < 2 && p[i].second) {
                    coo += p[i].first;
                    o++;
                }
                if (o >= 2) break;
            }
        }

        // cee: e e .. e o .. o e .. e e
        if (ec >= 2) {
            e = 0;
            for (int i = 0; i < n; i++) {
                if (e < 2 && !p[i].second) {
                    cee += p[i].first;
                    e++;
                }
                if (e >= 2) break;
            }
        }

        vector<ll> cd;
        cd.emplace_back(s - coe);
        cd.emplace_back(sa - coo);
        cd.emplace_back(s - cee);
        if (oc >= 4) cd.emplace_back(s - coo);

        s = *min_element(cd.begin(), cd.end());
    } else {
        s -= p[0].first + p[1].first;
    }

    cout << s << endl;
}

int main() {
    cin.tie(nullptr), cout.tie(nullptr), ios::sync_with_stdio(false);

#ifdef _SHIFTPSH
    freopen("_run/in.txt", "r", stdin), freopen("_run/out.txt", "w", stdout);
#endif

    int t;
    cin >> t;
    for (int _ = 1; _ <= t; _++) {
        cout << "Case #" << _ << endl;
        solve();
    }

    return 0;
}

ss는 다음의 합입니다.

s=∑i{mi,1+mi,2+mi,3+mi,4if li is even2mi,1+mi,2+mi,3+mi,4if li is odds=\sum_i \begin{cases}m_{i,1}+m_{i,2}+m_{i,3}+m_{i,4} &\text{if } l_i\text{ is even}\\ 2m_{i,1}+m_{i,2}+m_{i,3}+m_{i,4} &\text{if } l_i\text{ is odd}\end{cases}

sasa는 홀수 그룹이 22개인 경우 특수 처리를 해 주기 위한 값으로서 다음의 합입니다.

sa=∑i{2mi,1+2mi,2+mi,3+mi,4if li is even2mi,1+mi,2+mi,3+mi,4if li is oddsa=\sum_i \begin{cases}2m_{i,1}+2m_{i,2}+m_{i,3}+m_{i,4} &\text{if } l_i\text{ is even}\\ 2m_{i,1}+m_{i,2}+m_{i,3}+m_{i,4} &\text{if } l_i\text{ is odd}\end{cases}

배열 pp에는 모든 그룹들에 대해 홀/짝 정보와 mi,3+mi,4m_{i,3}+m_{i,4} 정보를 저장해 두고 정렬했습니다.

여담

이 문제는 오후 7시 33분에 한 번 수정되었습니다.

예약 시스템 문제에서 조건이 하나 빠져 있었습니다. 아래와 같이 명시했고, 제출 횟수를 20회로 늘릴 것입니다.

– 한 집합에 속한 예약자들은 모두 한 덩어리의 방들을 배정 받아야 한다. 한 덩어리의 방들이란 덩어리에 속한 어떤 방 두개에 대해서도, 덩어리에 속하고 인접한 방들을 통해서 이동이 가능하다는 의미이다.

그런 말이 쓰여 있지는 않았지만, 운이 좋게도? 당연히 연결 요소여야 최소일 것이라고 생각하고 풀었고, 문제를 맞을 수 있었습니다. 연결 요소가 아니어도 괜찮았을 경우, 다음과 같은 반례가 있습니다.

1
5 14
6 1 1 1 1 1 1
6 2 2 2 2 2 2
6 2 2 2 2 2 2
5 10 10 10 10 10
5 10 10 10 10 10

이 경우 아래와 같은 구성이 가능합니다.
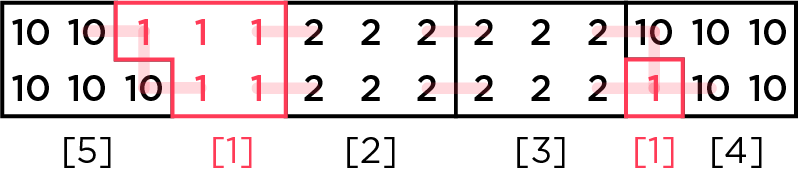
이 때 답은 8484입니다.

1차 5번 – 차이

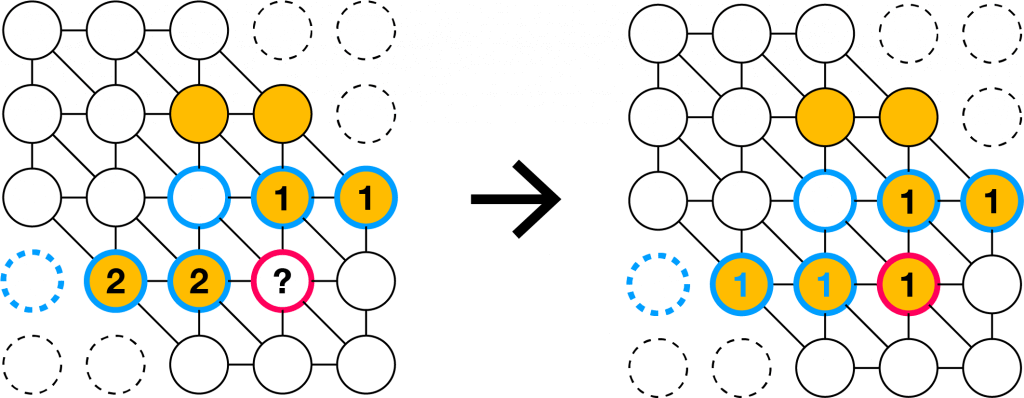
100 000100\,000개 이하의 미지수 XiX_i들에 대해 다음 쿼리들을 수행해야 합니다. 쿼리의 수는 200 000200\,000개 이하입니다.

  • 1 i j d: Xi+d=XjX_i + d = X_j라는 조건을 추가합니다.

  • 2 i j: Xi−XjX_i-X_j를 출력합니다. 조건이 모순된다면 CF를, 주어진 조건들만으로 알 수 없다면 NC를 출력합니다.


dd가 없다면 간단한 DSU 문제입니다. 이걸로 서브태스크 1과 3을 쉽게 해결할 수 있습니다.

DSU 트리의 간선들에 가중치가 있다고 생각한다면 서브태스크 2와 4를 해결할 수 있습니다.
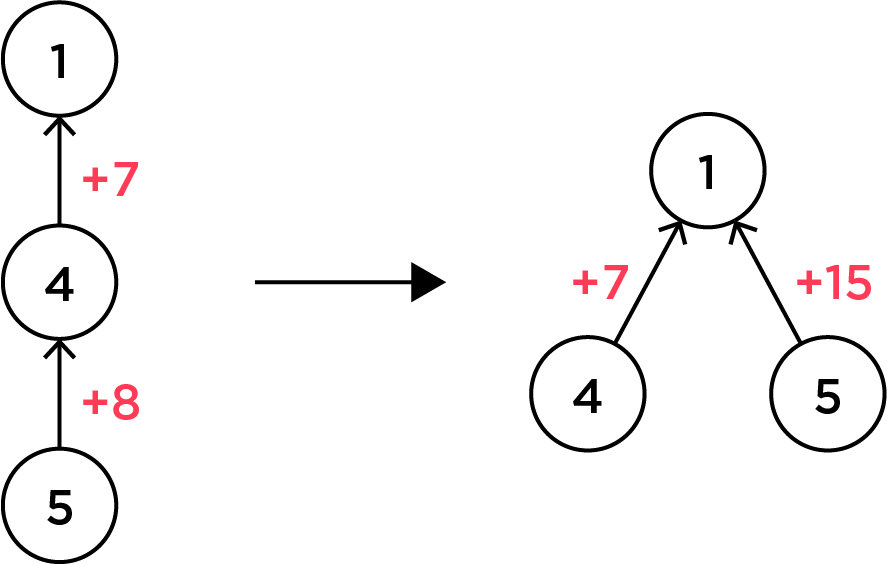
우리가 DSU 쿼리를 O(α(N))\mathcal{O}\left(\alpha\left(N\right)\right)만에 할 수 있는 이유는 경로 압축path compression이라는 좋은 테크닉이 있어서입니다. pup_u가 노드 uu의 부모 노드라고 한다면, uu의 루트를 구하는 함수 find\mathrm{find}에서 경로 압축은 다음과 같이 재귀적으로 수행했습니다.

find(u)={uif u=pupu←find(pu)otherwise\mathrm{find}\left(u\right) = \begin{cases} u & \text{if } u=p_u \\ p_u \leftarrow \mathrm{find}\left(p_u\right) & \text{otherwise} \end{cases}

이렇게 하면 uu에서 uu의 루트 rr로 가는 경로 위에 있는 모든 정점들의 부모가 아예 rr로 바뀌어 버리게 됩니다.

현재 노드 uu에서 부모 노드 pup_u로 가는 비용을 dud_u라고 합시다. 그러면 dud_u도 비슷한 방법으로 압축해버릴 수 있습니다.

find\mathrm{find} 함수를 돌릴 때 uu의 부모 노드는 pup_u였고, pup_u의 부모 노드는 rr이었습니다. 따라서 uu에서 rr까지 가는 데는 du+dpud_u + d_{p_u}만큼의 비용이 필요합니다. find\mathrm{find} 함수에서 경로 압축을 수행하면서, dud_u를 du+dpud_u + d_{p_u}로 업데이트해 주면 됩니다. 이제 가중치가 있는 DSU 트리에서도 경로 압축을 할 수 있습니다.

1번 쿼리와 2번 쿼리 모두 O(α(N))\mathcal{O}\left(\alpha\left(N\right)\right)만큼의 시간이 걸립니다. 총 시간 복잡도는 O(Kα(N))\mathcal{O}\left(K\alpha\left(N\right)\right)입니다.

α\alpha는 역 아커만 함수inverse Ackermann function이며, α(22265536−3)=4\alpha\left(2^{2^{2^{65536}}}-3\right)=4 정도로 작기 때문에 상수라고 생각해도 무방합니다.

#include <bits/stdc++.h>

using namespace std;
using ll = long long;
using ld = long double;
using pii = pair<int, int>;

/* [t] [c] [s] */

int dsu[100001], conf[100001];
ll val[100001]; // [u] + val[u] = [dsu[u]]

int find(int u) {
    if (dsu[u] == u) return u;
    int pp = find(dsu[u]);
    val[u] += val[dsu[u]], dsu[u] = pp;
    return pp;
}

bool merge(int u, int v, ll x) {
    // [u] + x = [v]
    if (find(u) == find(v)) {
        if (val[u] + x != val[v]) {
            conf[find(u)] = true;
            return false;
        }
        return true;
    }

    int pu = find(u);
    x += val[u];
    int pv = find(v);
    x -= val[v];
    u = pu, v = pv;
    val[u] = val[v] - x, dsu[u] = v;
    conf[v] |= conf[u];
    return true;
}

void solve() {
    int n, q;
    cin >> n >> q;

    iota(dsu + 1, dsu + n + 1, 1);
    memset(conf, 0, sizeof conf);
    memset(val, 0, sizeof val);

    while (q--) {
        int op;
        cin >> op;
        if (op == 1) {
            int i, j, d;
            cin >> i >> j >> d;
            merge(i, j, -d);
        } else {
            int i, j;
            cin >> i >> j;
            int pi = find(i), pj = find(j);
            if (pi != pj) {
                cout << "NC\n";
            } else if (conf[pi]) {
                cout << "CF\n";
            } else {
                cout << val[i] - val[j] << '\n';
            }
        }
    }

    cout.flush();
}

int main() {
    cin.tie(nullptr), cout.tie(nullptr), ios::sync_with_stdio(false);

#ifdef _SHIFTPSH
    freopen("_run/in.txt", "r", stdin), freopen("_run/out.txt", "w", stdout);
#endif

    int t;
    cin >> t;
    for (int _ = 1; _ <= t; _++) {
        cout << "Case #" << _ << endl;
        solve();
    }

    return 0;
}

conf는 모순이 발생했는지 여부를 저장하는 배열입니다. find 함수가 항상 루트를 찾아주기 때문에, conf 플래그도 맨 위에만 달면 충분합니다.


긴 시간 문제 푸시느라 모두 수고하셨습니다. 라운드 2에서 만납시다!
댓글 6개

목적지는 레이팅이 아니다

TechnologyProgrammingCompetitive Programming

이게 무슨 해괴망측한 소리일까요?

이 글은 알고리즘 문제해결 트레이닝에 대한 사견私見입니다.


지금부터 전제를 하나 합시다.

  • 밥 먹고 알고리즘 공부만 하면 얼마나 걸릴지는 몰라도 언젠가는 코드포스 레이팅 3,000이 될 겁니다.

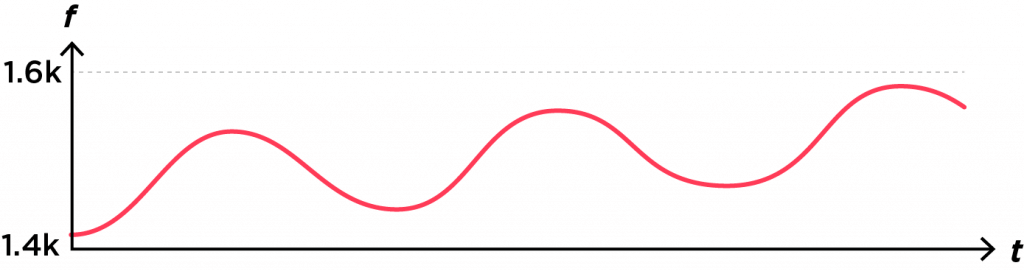
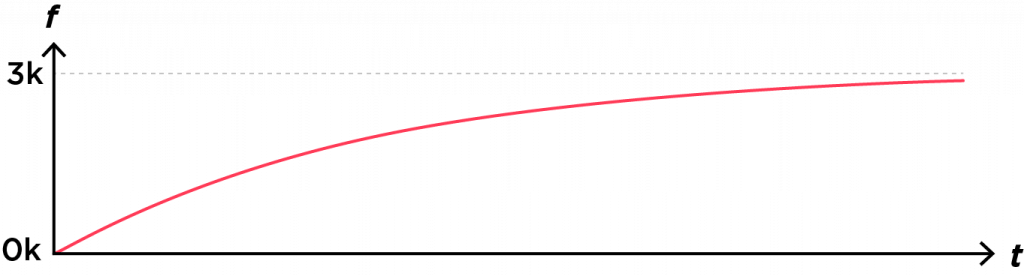
뭐, 세상에는 레이팅이 3,000을 넘는 괴물들도 다수 있지만 일단은 이론적으로 밥만 먹고 문제만 풀면 언젠가는 3,000에 갈 수 있다고 합시다. 사람마다 걸리는 시간은 다르겠지만요. 이를 근거로 공부한 시간 tt에 대한 실력 ff를 아래와 같이 모델링해 봅시다.

f(t)=3 000(1−at)f\left(t\right) = 3\ 000 \left(1-a^t\right)
공부한 시간 v. 레이팅

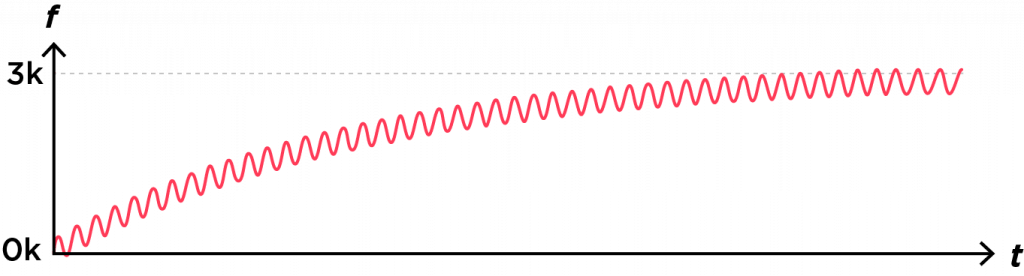
하지만 실력은 올라가기만 하는 건 아닙니다. 어떤 날은 컨디션이 좋아서 머리가 잘 돌아가고 문제가 잘 풀릴 수도 있는 반면 어떤 날은 피곤하거나 우울하거나 뭐 물리적으로는 손가락이 아프다거나 할 수 있죠. 그렇기 때문에 조금 더 정확하게 실력을 모델링하려면 노이즈를 끼워야 할 겁니다. 대충 아래와 같은 모델은 어떤가요?

f(t)=3 000(1−at)+bsin⁡(ct)f\left(t\right) = 3\ 000 \left(1-a^t\right) + b \sin \left(ct\right)
공부한 시간 v. 레이팅 (약간 더 현실적인 모델)

좋습니다. tt의 스케일이 얼마일지는 모르겠지만 이게 우리의 현재와 미래 실력을 대략적으로 모델링해준다고 합시다. 믿어 주세요.

하지만 제 레이팅은 계속 제자리인걸요

위 그래프에서 어떤 사람이 레이팅 1,400에서 1,600까지 가는 여정만을 한 번 살펴봅시다.

1,400 — 1,600

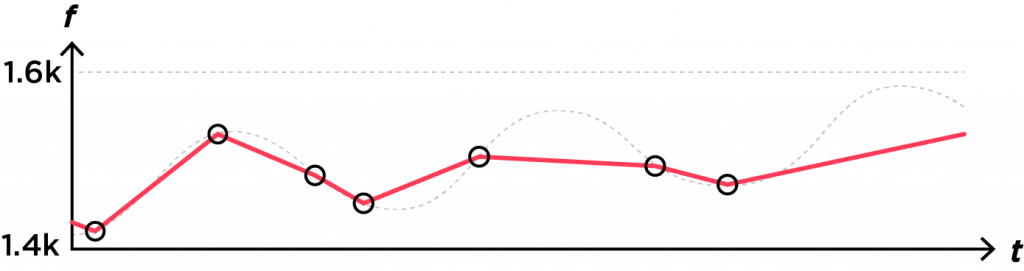
아마 가장 먼저 드는 생각은 이거일 거예요. ‘실력은커녕 내 그래프는 이거랑 비슷하지도 않은데…’ 맞아요. 쉽게 와닿지 않죠? 하지만 제가 여기에다 점을 몇 개 찍어볼게요.

1,400 — 1,600

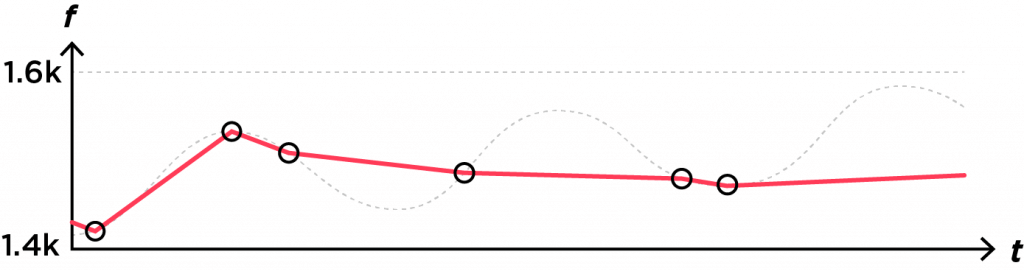
… 어떤가요, 있을 법한 그래프이지 않나요? 운이 정말 나쁘다면 이런 경우도 가능할 거구요.

4연속 하락

이 그래프의 주인공은 과연 영영 파란색 닉네임을 달지 못하게 되는 걸까요? 우리는 결국에는 1,600이 될 거라는 사실을 알고 있지만, 점선을 지우고 나서 이게 자신의 그래프라고 생각한다면 정말 슬플지도 모르겠네요…

사실 저도 경험해 봤습니다

대회는 실력의 샘플링에 불과하다

여기서 중요한 관찰이 하나 있습니다.

우리가 모델링한 실력 그래프와 코드포스 레이팅 그래프 사이에는 큰 차이점이 있습니다. 우리 그래프는 연속적이지만 코드포스 그래프는 그렇지 않다는 점입니다. 이는 ‘대회’라는 시스템의 본질에서 기인합니다.


대회는 우리 실력이 지금 이 순간 어땠는지만을 알려주지, 실력을 실시간으로 알려주지는 않습니다.


이게 왜 큰 차이냐면, 코드포스 레이팅 그래프가 우리의 실력을 정확하게 말해주지 않는다는 뜻이기 때문입니다.

한 마디로, 대회는 실력의 샘플링에 불과합니다. 심지어 샘플링 주기가 짧지도 않습니다. 그래서 사실 그래프에 찍힌 점들만 보고 거시적으로 어디로 갈지 예측하는 건 불가능에 가깝습니다. 위에서는 실력 기복을 bsin⁡ctb \sin ct라고 퉁쳤지만 사실 그렇지도 않을 거구요.

게다가 보통 한 대회에는 문제가 6개밖에 없기 때문에, 모든 분야가 고르게 출제될 수도 없으며, 운 나쁘게 내가 자신없는 분야가 출제되어서 평소보다 못 풀 수도 있습니다. 다시 말하면 샘플링 자체도 그렇게 완벽하지는 않습니다.

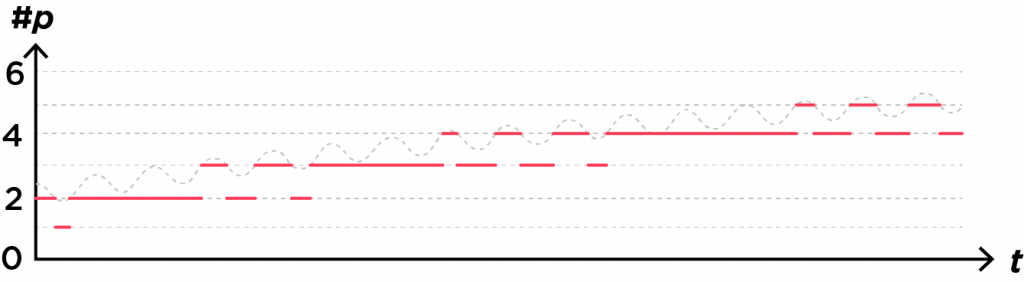
문제 수 이야기가 나와서 말인데 레이팅 말고 대회에서 해결한 문제 수로 바꿔서 생각해 볼까요? 코드포스에서는 몇 문제를 풀었는지가 레이팅을 결정하는 중요 요소로 작용하죠. 하지만 푼 문제 수는 보통 한 자리 정수입니다. 굉장히 이산적인데요, 대회마다 나오는 문제의 난이도가 일정하다고 하면, 위에서 만든 실력 모델링 그래프는 대략 아래처럼 됩니다.

문제 수로 봤을 때의 그래프

똑같은 3솔브여도, C를 간신히 해결한 3솔브와 D를 다 생각했는데 시간이 약간 부족해서 못 푼 3솔브는 다를 겁니다. 여유롭게 3솔브를 하고 아깝게 4번째 문제를 못 풀었다면 적어도 간신히 3솔브를 했을 때보다는 확실히 성장했을 테지만, 결과적으로 스코어보드에 보이는 건 똑같이 세 개의 초록색이겠죠.

마지막으로, 코드포스의 레이팅 공식조차 실력을 완벽하게 표현해 주지는 못합니다. 코드포스의 공식은 마지막으로 친 대회 결과에 상당히 큰 영향을 받도록 설계되어 있습니다. 최근 5개 정도 대회만 실력을 유의미하게 반영해 주는데요, 연속적으로 운이 좋거나 나쁘면 아예 색깔이 바뀔 수도 있는 시스템이라 평소 실력을 제대로 반영해 주지 못합니다. 관련해서는 djm03178님의 Codeforces 레이팅에 관련된 글을 읽어 보면 좋습니다.

그러니까 문제를 평소보다 못 풀어도 괜찮고, 레이팅이 떨어지더라도 괜찮아요. 애초에 그게 진짜 본인의 실력은 아닐 거예요.

그래서 목적지는 레이팅이 아니다

라고 말하고 싶습니다. 바꿔 말하자면, 레이팅은 진짜 실력이 아니고, PS 실력을 키우는 것과 레이팅을 올리는 것은 비슷해 보이면서도 다르다고 생각합니다.

물론 색깔을 바꾸기 위해 알고리즘 문제해결 공부를 하는 것도 정말 멋진 일입니다. 하지만 그 과정이 정말 지치고 힘이 든다면, 레이팅은 좋은 목표가 아닐지도 모릅니다.

하지만 실력을 키우면 레이팅은 자연스럽게 올라갈 거예요. 이런 마음가짐을 가지고, 대회를 충분히 많이 치면 언젠가는 목표하는 레이팅이 될 수 있다는 희망을 갖고, 나 자신의 가능성을 믿도록 합시다.

조금 현실적인 조언

  • 업솔빙 / 문제 수를 목표로 하기 — 그래도 해결하는 문제 수는 레이팅보다 직관적이면서도 그렇게 많이 변하는 값은 아니기 때문에 목표로서 유의미하다고 생각합니다.
    문제 레이팅을 목표로 하는 것과 맥락을 같이하는데요, 대회에서 풀었던 제일 어려운 문제의 다음 번 문제를 해결하려고 시도해 봅시다. 모르겠다면 에디토리얼을 보고 인사이트를 얻어갑시다. 아까운 실수로 틀렸다면 너무 자책하지 말고 오히려 자신을 격려해 줍시다. 뼈아픈 실수일수록 반복하는 일이 적을 거예요. 궁극적으로는 대회에서 해결할 수 있는 문제 수를 늘리는 것을 목표로 합시다.

  • 문제 레이팅을 목표로 하기 — 문제 수를 목표로 하는 것과 맥락을 같이합니다.
    코드포스 대회가 끝나면 Problemset에 문제 레이팅이 공개됩니다. 목표 문제 레이팅 rr을 정해 두고, 대회가 끝난 후 rr 이하의 문제들을 풀어보는 것으로 단련해 봅시다. 궁극적으로는 대회 시간 내에 rr 이하의 문제들을 안정적으로 풀 수 있는 것을 목표로 합시다.

  • 버추얼 컨테스트 돌리기 — 코드포스에는 끝난 대회를 가상 참가할 수 있는 기능이 있습니다. 또 가상 컨테스트 참여로 가상 레이팅을 계산할 수 있는 서비스도 있습니다. 이 서비스를 활용해 가상 컨테스트를 자주 치면 실력도 단련할 수 있고, 앞서 언급한 샘플링 주기의 문제도 어느 정도 해결할 수 있겠죠.

  • Atcoder — 일본 기반의 알고리즘 대회 사이트입니다. Atcoder는 코드포스의 레이팅 공식과 달리 현재까지 참여한 모든 대회의 퍼포먼스를 가중평균하는 식으로 레이팅을 계산하기 때문에 참가자의 평소 실력을 좀 더 잘 반영한다고 생각합니다. 게다가 문제도 코드포스보다 훨씬 깔끔하며, 시스텟이 없고, 무엇보다 시간대가 같아서 주말 오후 9시에 부담없이 참여할 수 있다는 장점도 있습니다. 강력하게 추천합니다.

  • 팀 연습 하다 오기 — 조금 더 긴 시간 동안 더 어려운 문제들에 대해서 생각해볼 수 있는 좋은 방법입니다. 새로운 인사이트를 얻을 수 있습니다.

  • 당분간 쉬기 — 너무 지쳤다면 괜찮아질 때까지 쉬어도 괜찮습니다. 알고리즘은 잊고 놀러 나가서 맛있는 거 먹고 옵시다. 금방 다시 회복할 수 있을 거예요.


알고리즘 문제해결이 여러분을 마음고생시키지 않았으면 좋겠어요. 여러분의 문제해결을 항상 응원합니다.


왜 AC RATING인가요?

solved.ac

solved.ac의 근간이 되는 두 가지 중요한 기능은 다음과 같습니다.

  • Baekjoon Online Judge 문제들에 난이도와 태그를 매겨서, BOJ에 있는 방대한 문제들 중 어떤 문제를 풀면 좋을지 훨씬 쉽게 고를 수 있는 수단을 제공합니다.

  • 푼 문제 수가 아닌, 푼 문제들의 난이도의 구성을 바탕으로 한 실력 지표와 이를 기반으로 한 순위 등을 제공해, 알고리즘 문제해결 학습자들에게 더 흥미로운 문제를 해결할 동기를 부여합니다.

실력 지표의 경우, 기존에는 문제를 해결할 때마다 경험치가 쌓이고, 푼 문제들의 경험치의 총 합을 기준으로 실력 지표인 티어를 결정했습니다. 이 방식은 solved.ac가 처음 만들어진 2019년 6월 6일부터 2년 가까히 이어져왔습니다만, 오는 1일부터는 새로운 실력 지표인 AC RATING으로 티어를 결정하게 됩니다. AC RATING은 아래의 합으로 결정되며, 이론적으로 3,450 이하의 정수 값입니다.

  • 푼 문제들을 난이도 순으로 내림차순 정렬했을 때, 상위 100개 문제의 난이도 값의 합 (최대 3,000)

  • CLASS에 따른 보너스 (최대 250)

  • 푼 문제 수에 따른 보너스 (최대 175)

  • 기여 수에 따른 보너스 (최대 25)

아니 잘 쓰던 경험치 냅두고 왜 이제 와서 이상한 조건의 레이팅을?이라고 생각하실까봐 레이팅제가 어떤 과정을 거쳐 탄생했는지에 대해 소개합니다.

경험치제의 문제점

기존의 경험치제를 간략하게 요약하면 이렇습니다.

  • 브론즈 5 문제를 해결하면 320점을 주도록 합니다. 어떤 문제보다 1티어 높은 문제의 경우 약 1.5배의 경험치를 주도록 합니다.

  • 브론즈 4 티어가 되려면, 브론즈 5 티어를 달성한 이후 브론즈 4 문제를 20문제 더 해결해야 하도록 합니다. 티어 xx가 되려면, 티어 x−1x-1을 달성한 후 난이도 xx의 문제를 nxn_x개 더 해결해야 하도록 합니다.

  • 기여 한 건마다 경험치 10,000을 줍니다.

이는 여러분께서 자신의 티어와 비슷한 난이도의 문제를 해결할 것으로 기대하고 기획한 것이었습니다. 하지만 여러 부작용이 있었습니다.

단적인 예로 아무것도 해결하지 않은 사람이 루비 1 문제 하나를 풀면 그 한 문제 덕분에 바로 다이아몬드 5가 됩니다. 알고리즘 실력을 키우고 싶은지 아닌지는 제쳐두고, 티어를 올리고 싶다면 힘들게 브론즈 실버를 캐면서 차근차근 올라갈 필요 없이 어려운 문제 하나만 풀면 되는 것입니다.

보통 그런 ‘어려운 문제’는 혼자 힘으로 해결하기 상당히 어렵기 때문에 인터넷을 참고해 해결하는 경우가 많고, 해결하는 순간 경험치 구성의 대부분을 차지해 버리게 됩니다. 이제 본인 실력의 문제를 해결하는 것으로는 경험치가 1%도 오르지 않습니다.

루비 V 한 문제가 경험치의 93.4%를 차지하는 극단적인 사례.

위 유저가 해결한 문제 중 가장 어려운 문제는 루비 V이고, 그 다음은 골드 II 한 문제, 골드 III 두 문제, 골드 V 열한 문제입니다.

기존 경험치제에서 이 유저의 티어는 플래티넘 V인데, 플래티넘 V 유저가 골드 V 한 문제를 풀어서 얻을 수 있는 경험치량은 0.411%입니다.

루비 V 한 문제를 풀지 않았다면? 이 유저의 티어는 실버 I이었을 것이며, 이 경우 골드 V 한 문제는 무려 6.02%의 경험치를 줍니다. 그러면 현재 루비 V 문제 하나를 해결한 상황에서 골드 V 문제를 푸는 게 과연 매력이 있을까요? 그렇다고 플래티넘 문제들을 푸는데 많은 시간을 소비할까요?

대부분의 경우, 의욕을 잃거나 새로운 어려운 문제를 찾아 떠나게 됩니다. 이런 점을 노린 코드 카피 어뷰징이 solved.ac가 등장한 이후 상당히 빈번하게 발생했습니다. solved.ac는 알고리즘 문제해결 학습자들의 학습 동기 증진을 목적으로 하는 사이트인데, 기존 경험치제가 학습자를 다소 좋지 않은 학습 방향으로 유도한다는 생각이 들었습니다.

또한 한 문제를 풀면 경험치를 얼마나 주는지, 다음 티어로 올라가기 위해서는 총 경험치가 얼마쯤 되어야 하는지 혹은 어떤 문제를 얼마나 해결해야 하는지 알기가 어려웠다는 사소한 문제도 있었습니다. 더구나 현재 1위의 총 경험치의 자릿수는 11자리나 되어 상당히 비직관적입니다.

레이팅제의 목표

기존의 제도에는 이런 문제점들이 있었고, 이를 어느 정도 해결하기 위해 많은 고민 끝에 새로 레이팅 제도를 만들었습니다. 새 레이팅 제도의 목표는 아래와 같았습니다.

  • 실력을 정확히 측정하는 것과 동기를 불러일으키는 것 사이 어딘가에서 적당히 줄다리기합니다. 둘 다 완벽하게 되면 더 좋고요.

  • 낮은 티어의 유저들이 새롭고 다양한 알고리즘 분야를 접하는 것을 장려합니다.

  • 푼 문제가 현저히 많다고 레이팅이 현저히 높아지거나, 어려운 문제 하나가 레이팅의 대부분을 차지하게 되는 현상을 최대한 완화합니다.

  • 직관적인 값으로 보여지도록 합니다.

  • 서버가 빠르게 계산할 수 있도록 합니다.

실력 측정 vs 동기 부여

기존의 경험치제나, 새로 도입하게 되는 레이팅제나 사용자의 정확한 실력을 반영해 주기 원하시는 분들이 많았습니다. 결론부터 말하자면 정확한 실력을 가늠하는 건 불가능했기 때문에, 레이팅과 실력과의 상관관계를 높이는 것은 목표로 하지 않았고, 기존과 같이 약한 상관관계를 보이게 하는 것으로 만족했습니다.

정확한 실력을 가늠하는 것이 불가능한 이유는 BOJ가 OJ이기 때문입니다. OJ에 등록된 문제들은 이미 어딘가에서 출제되었던 문제들이고, 많은 경우 쉽게 해설을 찾아볼 수 있습니다. 반면 대회 플랫폼의 경우 매번 새로운 문제들을 주고 틀린 횟수와 해결 시간을 바탕으로 실력을 계산합니다.

따라서 OJ 쪽은 대회 플랫폼에 비해 유저의 실력을 계산하기 위해 사용할 수 있는 정보와 그 정보의 신뢰도 모두가 현저히 떨어집니다. 심지어 대회 플랫폼의 레이팅도 정확한 실력을 반영한다고는 할 수 없습니다. 대회는 실력을 샘플링하는 것에 지나지 않기 때문입니다. 수능 모의고사에서 1등급을 받은 학생이 수능에서도 같은 등급을 받을 것이라는 보장이 없듯이요…

이런 이유로 레이팅과 실력과의 대략적인 상관관계는 기존 수준으로 유지하되 새 레이팅 제도가 목표로 하는 동기 부여적 측면을 더 부각시킬 수 있는 쪽으로 기획 방향을 정했습니다.

레이팅의 뼈대

무작정 높은 난이도의 문제를 푸려고 하게 되는 이유는, 높은 난이도의 문제가 푸는 데 오랜 시간이 걸림에도 불구하고 티어 상승이라는 측면에서 상당히 매력적으로 보이기 때문입니다.

기존 경험치제에서 루비 I 문제 하나를 푸는 것은 브론즈 V 문제 약 30만개를 푸는 것과 비슷한 경험치를 줬고, 이는 문제해결에 쏟는 시간 대비 엄청난 가성비를 보여줍니다. 모든 티어에서 상당히 매력적으로 보이는 게 당연합니다. 따라서 매력을 너프하기 위해서는, 일단 문제 해결로 얻는 경험치가 난이도에 따라 기하급수적으로 올라가는 식이 아니어야 합니다.

하지만 그렇게 되면 난이도에 관계없이 문제를 많이 해결한 사람이 무조건 유리해집니다. 레이팅이 적용된 다른 OJ들이나 비슷한 구조의 게임들이 이를 막는 방법은 크게 두 가지가 있습니다.

  • 반영되는 문제 수에 제한을 둡니다. nn문제를 반영한다면, 어떤 사용자가 난이도 xx까지의 문제를 해결할 수 있을 때 이론적으로 받을 수 있는 최대치는 nxnx입니다.

  • 모든 문제를 반영하되 적당한 상수 0<r<10<r<1을 정해서 첫 문제에는 11을, 두 번째 문제에는 rr을, 세 번째 문제에는 r2r^2를 곱해나가는 식으로 합니다. 어떤 사용자가 난이도 xx까지의 문제를 해결할 수 있을 때 이론적으로 받을 수 있는 최대치는 x1−r\frac{x}{1-r}입니다.

두 방법은 사실상 같습니다만 첫 번째 방법은 서버가 계산하기 쉬운 대신 특정 난이도 이상의 문제를 풀지 않으면 아무리 문제를 풀어도 레이팅이 아예 오르지 않는다는 단점이 있고, 두 번째 방법은 문제를 풀면 레이팅이 계속 오르겠다는 믿음을 주는 대신(실제로는 1점 올리기는 상당히 어렵습니다) 서버가 레이팅을 계산하는 코스트가 조금 더 든다는 단점이 있습니다.

그래서 문제를 풀면 레이팅이 오르겠다는 믿음은 다른 방법으로 주기로 하고 첫 번째 방법을 택했습니다. 100문제를 해결하면 레이팅이 수렴했다고 보고, 푼 문제들을 난이도 순으로 정렬해 상위 100개 문제의 난이도 값의 단순합을 레이팅의 가장 많은 부분을 차지하도록 했습니다. 공교롭게도 solved.ac의 문제 난이도는 0부터 30까지라서 이렇게 하면 총 3,000점이 되고, 다른 대회 플랫폼들의 4자리수 레이팅과 비슷한 값이 되어 직관적이게 됩니다.

상위 100문제의 난이도 합으로 결정

여기에 문제 해결 수에 따른 보너스 레이팅을 ⌊175(1−0.995n)⌉\left\lfloor 175\left( 1-0.995^n \right) \right\rceil만큼 주어 약 1,200문제를 해결할 때까지 어느 문제나 해결해도 레이팅이 오른다는 믿음을 주도록 유도했습니다. 다만 실제로 믿으실지는 모르겠습니다. 믿어 주세요.

기존 기획은 이 100문제를 (5년간 출제된 OI/ICPC 문제) 50개와 나머지 문제 50개를 반영하려 했으나, 그렇게 할 근거가 부족하여 100문제를 합하는 것으로 선회했습니다.

새롭고 다양한 알고리즘 문제해결 장려

이미지
CLASS

solved.ac에는 티어 외에도 CLASS라는 실력 지표가 있습니다. 실력대별로 미리 정해진 48문제 중 20문제 이상을 해결하면 얻을 수 있습니다.

CLASS 문제들은 수준에 따라 교육적인 목적을 갖고 정해져 있습니다. 예를 들어,

  • CLASS 1는 프로그래밍 혹은 알고리즘 문제해결 입문자가 풀어보면 좋을 만한 문제들로 구성했습니다.

  • CLASS 2는 코딩 테스트나 프로그래밍 대회 등에서 자주 등장하는 주제들 중 초심자가 이해하고 구현하기 쉬운 주제들로 구성했습니다. (브루트포싱, 기초 수학, 정렬, 큐, 스택, 덱)

  • CLASS 3은 CLASS 2에서 등장한 주제들을 전부 이해하고 나서 시도하면 좋을 만한 주제들로 구성했습니다. (그래프, 그래프 탐색, 힙, 우선순위 큐, 다이나믹 프로그래밍 등)

  • CLASS 4는 CLASS 3과 비슷하지만 더 어렵다고 느껴지는 주제들을 담았습니다. (백트래킹, 최단 경로 문제, 어려운 구현, 어려운 다이나믹 프로그래밍, 어려운 그래프 문제 등)

낮은 CLASS 문제들은 ‘단계별로 풀어보기’와 비슷한 구성으로 초심자가 가면 좋을 만한 길을 추천해 주는 것을 목표로 했습니다. 이를 더더욱 권장하기 위해 레이팅에 CLASS 보너스를 추가했습니다. 다만, 새 레이팅과 실력과의 괴리가 생길 것을 감안해 낮은 티어에서는 CLASS 보너스가 매력적으로 보이지만 높은 티어에서는 CLASS 보너스의 유무가 랭킹에 큰 차이를 주지 않도록 다음과 같이 정했습니다.

  • CLASS 1, 2: +25점

  • CLASS 3, 4, 5: +50점

  • CLASS 6~: +10점

CLASS 6부터는 주로 프로그래밍 대회에만 등장하는 어려운 주제들을 다루고 있습니다. 또한 CLASS 6 이상을 취득할 수 있는 실력의 사람이라면 CLASS 5 정도는 쉽게 취득할 수 있고, 굳이 CLASS 문제를 해결하지 않더라도 실력을 늘릴 방법을 많이 알고 있을 것이라고 생각했기 때문에 CLASS 6 이상에서의 레이팅 보상은 랭킹에 크게 영향을 미치지 않는 방향으로 결정했습니다.

레이팅 컷

레이팅에 따른 티어는 크게 두 가지 요소를 고려해 정했습니다.

  • 티어 xx의 유저 입장에서 티어 x+1x+1로 가기 위한 과정에서의 경험은 적절한가

  • 티어에 따른 유저 비율이 어떻게 변화할 것인가

특히 새로운 레이팅 제도에서는 상위 100문제를 반영하고 있는데, 알고리즘 공부를 막 시작한 입장에서는 100문제를 해결하는 것부터 버거울 수 있겠습니다. 따라서 ‘몇 CLASS이길 기대하는가?’와 더불어 낮은 티어의 경우 ‘몇 문제를 해결하는 것을 기대하는가?’를 고려했습니다. 예를 들자면

  • 기존 경험치제의 브론즈 구간에서는 실력에 맞는 문제를 약 30문제 정도를 해결하는 것을 기대했습니다. 새로운 레이팅제에서는 CLASS 1~2를 해결하는 여정을 고려하여 레이팅 컷을 정했습니다.

  • 골드 구간부터는 100문제 이상 해결을 기대하고, 상위 100문제에서 기대하는 난이도 평균을 고려했습니다. 예컨대 골드 III 유저는 평균적으로 클래스 2~3에 실버 II에서 골드 V 수준의 문제를 쉽게 해결할 수 있을 것으로 생각했습니다. 클래스 5를 달아 레이팅 100~150을 챙기고, 클래스 5를 풀면서 골드 상위~플레 하위 문제들에 익숙해져 상위 100문제를 그렇게 구성한다면 어느새 플래티넘이 되어 있을 것입니다.

  • 이론적인 레이팅 만점은 3450이지만 루비 구간의 문제들이 부족하고 상위 100문제가 이미 다이아몬드와 루비로 꽉 차 있는 상황에서 더 어려운 루비 문제를 해결하는 것 자체가 상당히 어려운 과정임을 감안해 루비 구간은 촘촘하게 나눴습니다.

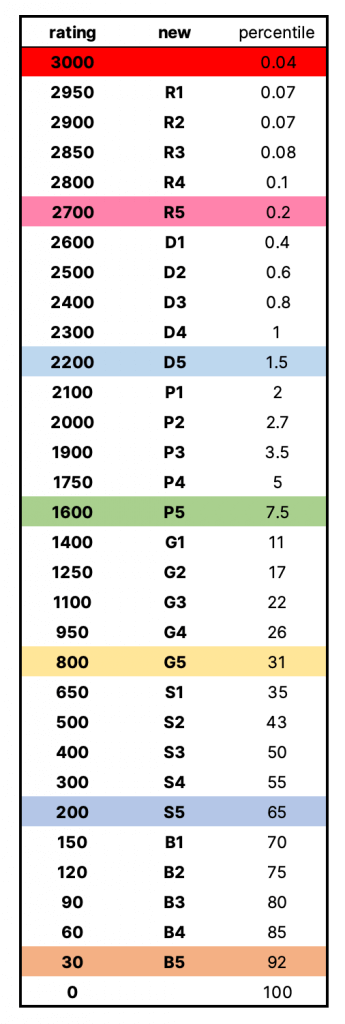
그렇게 하면서도 레이팅 컷이 직관적인 수가 되도록 했습니다 – 브론즈 30, 실버 200, 골드 800, 플래티넘 1600, 다이아몬드 2200, 루비 2700. 이렇게 각각의 티어에서 많은 고민 끝에 레이팅 컷을 정했습니다.

새 레이팅 컷

플래티넘, 골드, 실버, 브론즈가 각각 상위 10%, 33%, 67%, 100%가 되는 것이 이상적이라고 생각하고 있습니다만, 당시 레이팅 공식이 공개되지 않았음을 고려해 기존보다 약간 더 어렵게 설정했습니다. 레이팅 공식이 공개되는 것이 유저 비율에 영향을 미칠 수 있어서입니다.

레이팅 vs 기존 실력 지표

(왼쪽) 새 티어와 코드포스 레이팅의 상관관계, (오른쪽) 기존 티어와 코드포스 레이팅의 상관관계

신규 레이팅제에서, 코드포스 아이디가 존재하는 상위 569명을 대상으로 코드포스 레이팅과 새 티어를 비교한 결과 기존 티어에 비해 상관관계가 약해졌습니다만, 기존과 같이 어느 정도의 상관관계는 유지하는 양상을 보였습니다. Inversion count도 기존 148,135회에서 161,462로 증가했습니다. 기존 경험치제의 문제점을 해결하기 위해 실력과의 상관관계를 다소 희생했으나, 여전히 어느 정도 유의미한 상관관계를 가진다고 해석했습니다.

극복해야 할 과제

새로운 레이팅제도 완벽하진 않습니다. 대표적으로 1,200문제를 해결해 문제 수 보너스 175점을 모두 받은 유저의 경우, 새 레이팅제에서는 상위 100문제보다 낮은 난이도의 문제를 해결하는 것의 의미가 없어집니다. 충분히 흥미로운 문제가 있을 수도 있지만요. 또한 CLASS 보너스 레이팅을 산입하는 것이 좋은 선택인가에 대한 논의도 있었습니다.

이런 부분들에 대해서는 레이팅제로 운영해보면서 어떻게 개선할 수 있을지에 대해 고민해 보기로 했습니다. 길라잡이 컨텐츠를 잘 만드는 것 등 레이팅 공식 외적으로도 개선할 수 있는 부분이 있을지도 모르겠습니다.

티어를 어떻게 결정할지를 정하는 것은 solved.ac 전체를 통틀어 가장 어려운 기획입니다. 그만큼 수많은 고민 끝에 만들어진 기획인데, 고민한 만큼 긍정적으로 정착하면 좋겠습니다.


이후 계획

제가 직장인이 되었고 또 여러가지 일들로 바빠지다 보니 solved.ac에 새로운 컨텐츠를 만들 시간이 상대적으로 부족해졌습니다. 현재 계획하고 있는 것들은 이렇습니다.

  • 백엔드 리팩터링(~6월). 프론트엔드에 이어 백엔드입니다. 현재 백엔드는 PHP인데, 유지보수가 너무 어려운 상황이라 Express로 다시 짜고 있습니다. solved.ac를 처음 만들 시절엔 이렇게 커질 줄 몰랐으니까 어쩔 수 없는 것 같습니다. 프로젝트를 시작할 때부터 기반을 잘 닦읍시다.

  • 길라잡이(~9월).

  • 투표 개편(~9월).

앞으로도 많은 관심과 기대 부탁드리겠습니다!

Prop `className` did not match

TechnologyProgrammingWeb Frontend

Next.js + styled-components에서 Prop `className` did not match가 발생하는 이유와 해결 방법

작년 가을에 solved.ac 프론트엔드를 Typescript로 리팩터하면서 당황스러운 경험을 했습니다. 사이트 내의 아무 링크나 클릭해서 다른 페이지로 가면 스타일시트가 전부 깨지는 것이었습니다.

콘솔을 열어 보니 다음과 같은 에러가 뜹니다.

Warning: Prop `className` did not match. Server: "sc-xxxxxx xxxxx" Client: "sc-yyyyyy yyyyy"

오류에서 알 수 있듯이 서버와 클라이언트에서 클래스네임이 일치하지 않아서 발생한 오류임을 알 수 있습니다. Next.js는 SSRServer-side Render을 도와주는 프레임워크입니다. SEO검색 엔진 최적화 등을 위해 처음 페이지를 로드할 때는 서버에서 렌더해 오지만, 페이지에서 링크를 클릭해 다른 페이지로 넘어갈 때는 CSR로 페이지를 렌더합니다. SEO와 속도 두 가지를 해결해 주는 프레임워크죠.

그럼 서버와 클라이언트는 기본적으로 같은 로직을 공유할 텐데 왜 이런 일이 일어나는 걸까요?

babel-plugin-styled-components가 없어서

첫 번째 이유는 babel-plugin-styled-components가 없어서입니다. 이 Babel 플러그인은 환경과 상관없이 일관된 className을 생성(consistently hashed component classNames between environments)해 줍니다. 헐 그럼 styled-components는 이 플러그인 없으면 기본적으로 className 생성을 ‘환경’에 의존한다는 뜻인가요 네 그렇습니다.

styled-components는 styled 함수로 만든 컴포넌트마다 generateId 함수를 이용해 유일한 식별자를 생성하는데요, 함수에서 확인할 수 있다시피 전역 카운터를 하나 두고 컴포넌트 하나를 처리할 때마다 증가시켜 가면서 생성됩니다.

위의 방법으로 식별자를 생성하면 어떤 일이 일어날 수 있을까요? 컴포넌트가 생성되는 순서에 따라 같은 컴포넌트이더라도 다른 식별자가 붙을 수 있게 됩니다! CSR에서는 상관없겠지만 SSR과 CSR을 같이 활용하는 경우 서버와 클라이언트가 컴포넌트를 생성하는 순서에 따라 식별자가 달라질 수 있습니다. babel-plugin-styled-components는 이런 식별자 생성 과정을 정규화해 줍니다.
다음과 같이 해결할 수 있습니다.

1. 플러그인 설치:

npm i --save-dev babel-plugin-styled-components

2. 프로젝트 루트의 .babelrc 편집(없을 경우 생성):

{
  "plugins": ["babel-plugin-styled-components"]
}

3. Next.js를 사용 중인 경우 이곳의 _document.js를 복붙해 오세요.

그래도 안 돼요

이 포스트의 핵심입니다.

solved.ac의 경우에는 저걸 다 했는데도 안 되길래 몇 달 내내 이거 고치려고 삽질을 했습니다. Typescript로 리팩터링하기 전엔 없던 문제였는데 Typescript를 들고 오면서 생긴 오류라, 뭐가 문제인지 찾아보다가 커스텀 테마 타입 정의 때문이라는 걸 알았습니다.

solved.ac 프론트엔드 코드에는 SolvedTheme라는 타입이 있고, 여기에 테마 정의를 넣습니다.

interface SolvedTheme {
  defaultFonts: string
  codeFonts: string
  background: string
  textColor: string
  textColorInverted: string
  textSecondaryColor: string
  border: string
  borderColor: string
  tableHeaderBackground: string
  tableBackground: string
  footerBackground: string
  primaryColor: string
}

기존의 경우 styled-components로 만든 컴포넌트에서는 이를 아래와 같은 식으로 활용해 왔습니다.

const TopBarContainer = styled.div`
  position: fixed;
  width: 100%;
  height: 48px;
  line-height: 48px;
  background: ${({ theme }) => theme.background};
  border-bottom: ${({ theme }) => theme.border};
  top: 0;
  left: 0;
  z-index: 10000;
`

Javascript에서는 문제가 없는 코드이지만 Typescript에서는 컴파일 에러가 납니다. theme의 타입이 위에서 정의한 SolvedTheme가 아닌 styled-components에 내장된 DefaultTheme이기 때문입니다.

우선 이 문제를 해결하기 위해 열심히 구글링을 했고, styled-components를 아래와 같이 제 타입 정의로 감싼 뒤 이렇게 만들어진 새로운 styled를 여기저기 import 해 와서 사용했습니다. import styled from '../styles/Themes' 같은 식으로요.

import * as styledComponents from 'styled-components'
import { ThemedStyledComponentsModule } from 'styled-components'

const {
  default: styled,
  css,
  createGlobalStyle,
  ThemeProvider,
  ThemeConsumer,
  keyframes,
} = styledComponents as ThemedStyledComponentsModule<SolvedTheme>

export { css, createGlobalStyle, keyframes, ThemeProvider, ThemeConsumer }
export default styled

그런데 이렇게 정의해 버리면 babel-plugin-styled-components가 의미가 없어집니다. babel-plugin-styled-components는 import 경로가 ‘styled-components’인 경우에만 작동하기 때문인데요.

옵션에서 바꿀 수 있어 보이지만 깔끔한 해결책은 아닌 거 같고, 대신 styled.d.ts를 새로 만들고 여기에서 DefaultTheme를 SolvedTheme으로 두면 됩니다. 그러면 위의 문제를 해결하면서 커스텀 테마의 타입 정의도 사용할 수 있습니다.

import 'styled-components'
import { SolvedTheme } from './Themes'

declare module 'styled-components' {
  export interface DefaultTheme extends SolvedTheme {}
}

(21/12/23 수정: 코드가 declaration merging을 사용하도록 수정했습니다. type DefaultTheme = SolvedTheme로 하는 경우에는 VS Code 에디터 자동완성 등의 기능을 제대로 활용하지 못했습니다.)

일반적인 원인은 아닐지 모르겠지만, 제가 영문도 모르고 몇 달간 고생한 걸 다른 분들이 겪지 않았으면 하는 마음에서 제 사례를 소개했습니다.

참고한 리소스


이른바 명예로운 자가격리를 당한 거지

LifeYearly Review

2020년 회고

강변북로 사진
서강대교에서 찍은 강변북로

올해부터 블로그에 1년 단위로 뭘 했는지 회고를 써 보기로 했습니다. 나중에 잊어버리면 슬프잖아요.

애초에 애인도 친구도 없어서 약속 없는 핑계를 코로나 때문이라고 둘러댈 수 있는 좋은 한 해였습니다. 이른바 명예로운 자가격리를 당한 거죠. 저희 집에서 가장 가까운 박쥐 동굴 방향으로 하루에 세 번 절하고 있습니다.

그래도 코로나가 12월에는 끝나있을 줄 알았는데 그것도 아니더라구요. 일일 확진자 수 최고치 연일 갱신 중이고 저는 집에서 재택근무를 하고 있습니다. 엇 그래도 이제 직장은 있군요 다행이에요

소프트웨어 개발

solved.ac

이미지
살아남았다

올해는 solved.ac 개발에 꽤 집중했습니다. 올해 솔브드에 새로 생긴 큼직한 기능들은 다음과 같습니다.

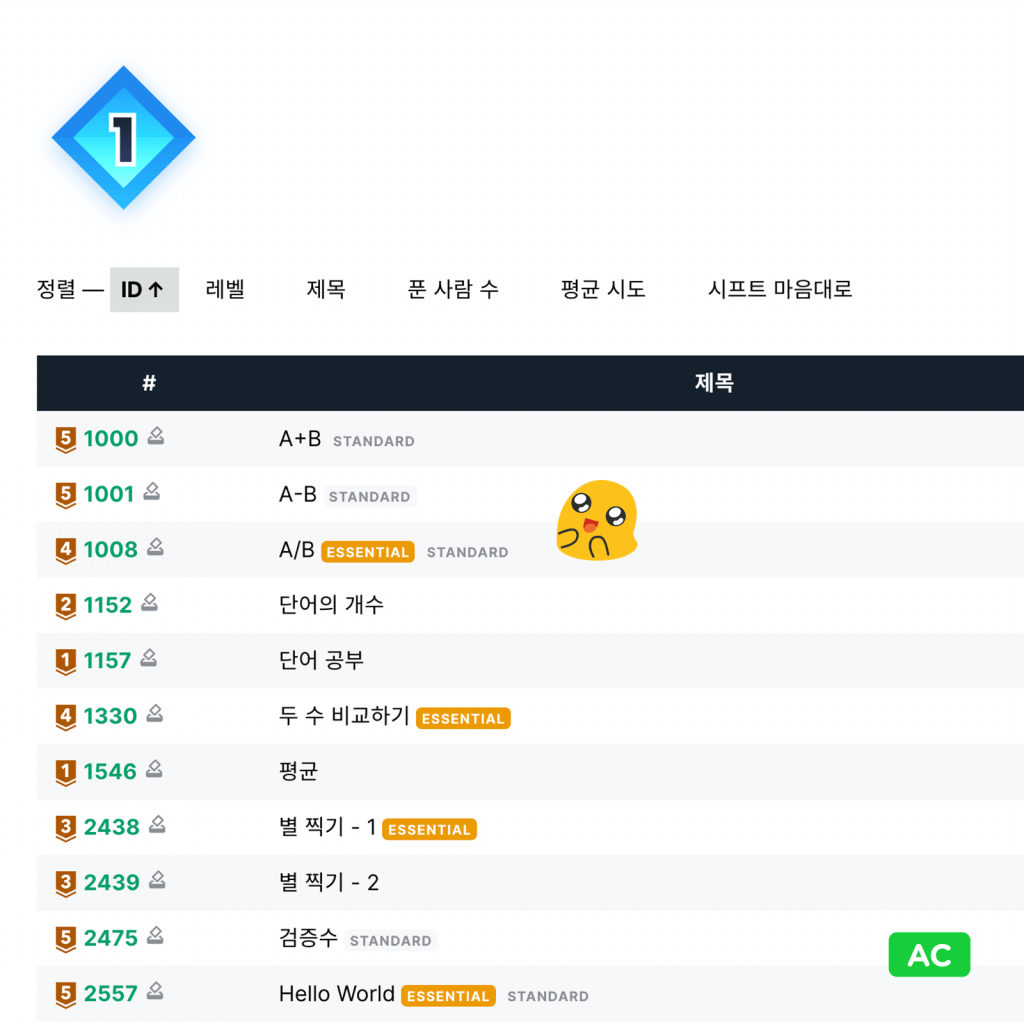
  • 문제 정렬. (2월) 문제 목록에서 문제 순서를 쉽게 정렬할 수 있습니다.

  • 고급 검색. (2월) 문제 제목뿐 아니라, 맞은 사람 수, 문제 레벨, 내가 푼 문제 등에 필터를 걸 수 있고, AND, OR 등의 연산자를 이용해 검색하는 것이 가능해졌습니다. 검색 쿼리 문법을 직접 만들고, 이를 해석하는 파서 등도 만들었습니다.

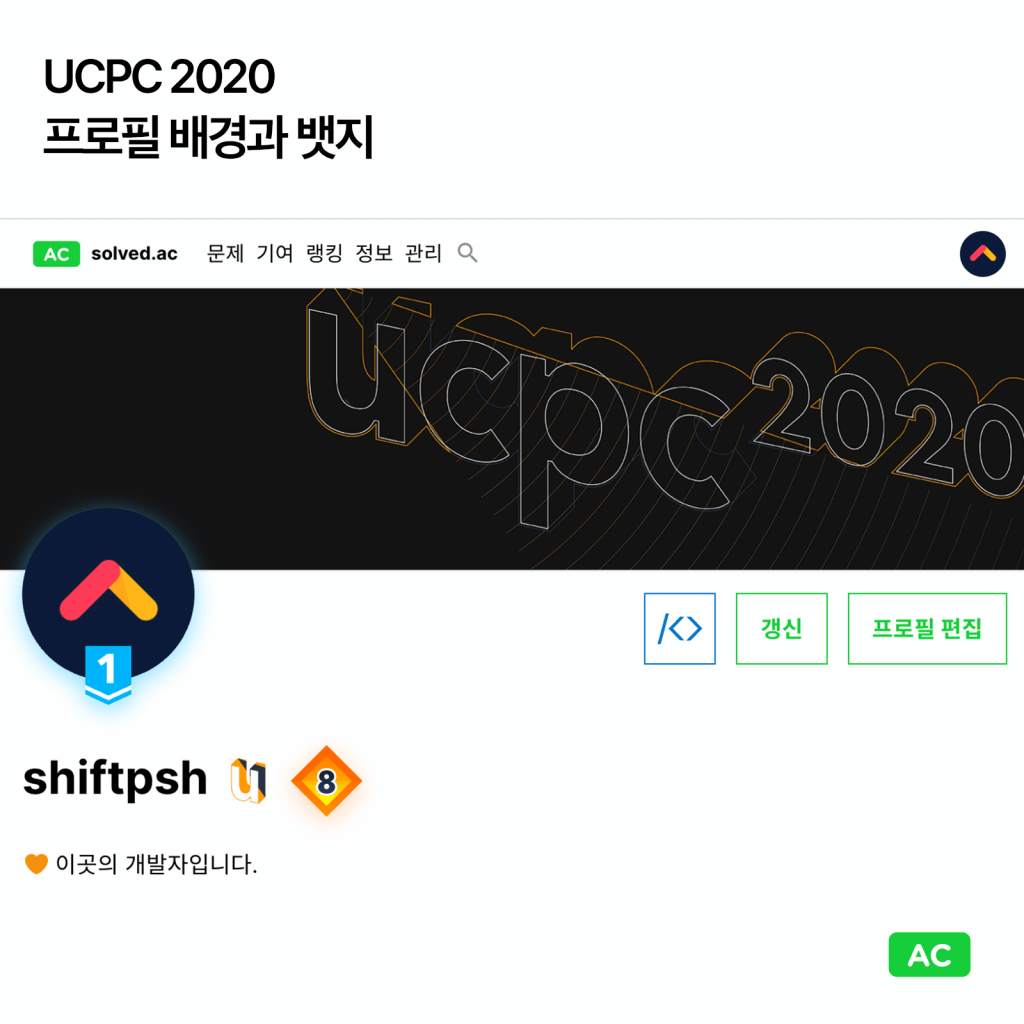
  • 프로필 배경. (2월) 프로필을 배경으로 꾸밀 수 있게 되었습니다.

  • 라이벌. (4월) 다른 유저를 라이벌로 등록하고, 라이벌들과 나의 순위를 볼 수 있습니다.

  • 프로필 사진. (5월) 프로필 사진을 올릴 수 있게 되었습니다.

  • 화이트리스트제 종료 및 베타 종료. (6월 5일) 지금은 상상하기 힘들지만, 6월 이전에는 솔브드를 사용하려면 제게 이메일을 보내서 화이트리스트에 등록되어야 했습니다. 6월부터는 기존처럼 크롤링 및 파싱을 하는 방식에서 BOJ에서 유저 정보를 직접 받아오는 방식으로 바뀌어서, 누구나 사이트를 사용할 수 있게 되었습니다.

  • 코드 교환. (8월) 리딤 코드를 입력해 배경과 프로필 뱃지 등을 교환할 수 있게 되었습니다.

  • 자동 갱신. (11월) 이것도 지금은 상상하기 힘들지만, 11월 이전에는 문제를 풀고 나서 프로필에 있는 ‘갱신’ 버튼을 직접 눌러줘야 했습니다. 지금은 문제를 푸는 즉시 경험치가 반영되기 때문에 굳이 갱신 버튼을 누를 필요가 없습니다.

이제 BOJ와의 통합 작업도 거의 마무리되어 solved.ac에 굳이 들어오지 않고도 BOJ에서 solved.ac 문제 난이도와 태그 정보를 확인할 수 있게 되었습니다. 또한, 길라잡이 등의 새로운 기능들이 공개를 앞두고 있습니다. 내년에도 잘 부탁드려요!

Javascript 프레임워크의 세계로

solved.ac의 소스 코드는 원래 대부분 PHP로 되어 있었습니다. 프론트엔드 코드가 복잡해지면서 유지보수에 무리가 갔고, PHP의 특징적인 여러 요소들 때문에 코드 베이스가 PHP인 이상 추가적인 무언가를 개발하기는 힘들겠다 싶었습니다.

그래서 컴포넌트를 만들고 재사용하기 좋다고 들은 React로 무작정 프론트엔드 포팅을 시작했습니다. 검색엔진 최적화도 해야 해서 SSR을 지원해 주는 Next.js도 같이 사용했고요.

당시에는 리액트에 대해 하나도 몰랐지만 지금은 현업에서 매일 사용하고 있을 정도로 익숙해지기 쉬운 프레임워크라고 느낍니다. 진작에 이걸 왜 안 했지? 싶을 정도로요. 참고로 리액트를 쓰기 이전에는 제가 만들었던 사이트들은 아무 프레임워크도 사용하지 않고 오직 vanilla JS로만 돌아갔습니다.

이후에는 Typescript도 적용해 프로젝트를 리팩터했습니다. 타입 추론이 상당한 개발 효율을 가져다주는 것을 체감할 수 있었습니다. 가령 기존에는 API response에 대한 타입 정의가 없어서(게으르게도 명세도 딱히 해 두지 않았었습니다), 필드나 타입을 헷갈려서 오류가 발생하거나 개발 속도가 느렸었는데, 지금은 타입 정의를 열심히 만들어서 제 human error로 오류가 발생할 수 있는 가능성을 대폭 줄였습니다. 되게 기본적인 거지만 나름 뿌듯했던 경험이라 소스 코드를 첨부해 공유해 봅니다.

type SolvedPageContext = NextPageContext & GlobalProps

export type SolvedPage<
  P = { siteTitle?: string[] },
  IP = P
> = NextComponentType<
  SolvedPageContext,
  IP & { siteTitle?: string[] },
  P & { siteTitle?: string[] }
>

export default SolvedPageContext

이렇게 정의하면 페이지의 Props의 타입 정의가 어떤지에 따라 getInitialProps에서 반환해 줘야 하는 타입이 결정됩니다. 아래 페이지의 경우 props.result의 타입이 Problem[]으로 정해져 있기 때문에 ProblemList에서 렌더 로직을 짜기가 상당히 편해집니다. 에디터 연동은 두말할 것도 없구요.

type Props = SolvedApiResponse<SearchProblems>

const LevelProblems: SolvedPage<Props> = (props) => {
  // ...
  return (
    <PageLayout>
      <h1>
        <TierMark value={level} locked={false} showName={true} />
        {caption ? ` — ${caption}` : null}
      </h1>
      <ProblemSortController
        currentSort={newQuery.sort}
        currentDirection={newQuery.direction}
      />
      <div>
        <ProblemList
          result={props.result}
          page={page}
          keys={['id', 'title', 'solved_count', 'average_try']}
        />
      </div>
    </PageLayout>
  )
}

LevelProblems.getInitialProps = async (ctx) => {
  // ...
  try {
    const response = await SolvedApi<SearchProblems>(token).get(
      '/search/problems.json',
      {
        params: {
          query: queryString,
          page: +(page ?? 1),
          sort: sort ?? ctx.currentSettings?.problem_sort_by,
          sort_direction:
            direction ?? ctx.currentSettings?.problem_sort_direction,
        },
      }
    )
    return {
      siteTitle: ['문제', '레벨', levelName(+(level ?? 0))],
      ...response.data,
    }
  } catch (e) {
    // ...
  }
}

여하튼 이런 식으로 기존에 PHP로 짜여 있었던 프론트엔드를 몇 달에 걸쳐 전부 React + Typescript + Next.js로 다시 짰습니다.

안타깝게도 백엔드는 아직도 PHP로 되어 있습니다. 현재는 길라잡이를 만들면서 백엔드도 Node + Express로 다시 구현하려는 계획을 갖고 있습니다. 완료되면 solved.ac에서 PHP 코드를 찾아보기 힘들게 되겠네요.

취업

넥하

위의 개발 경험 덕분에 6월 중순부터 넥슨컴퍼니 산하의 엔진스튜디오에서 일하게 되었습니다. 회고를 쓰고 있는 지금 시점으로 입사한 지 벌써 반 년이 넘었네요.

게임회사지만 제 주 업무는 웹 프론트엔드 엔지니어입니다. 사내외 여러 서비스의 개발을 맡아 하고 있습니다. 어떤 서비스라고 말하긴 그렇지만 아마 이 글을 읽고 계신 분들 중 적지 않은 분들께서 제가 작업했던 서비스를 이미 사용해 보셨을 겁니다. 😉

이미지
서버는 오로라

여담으로, 회사에서 매달 넥슨캐시를 일정량 지급하는데 쓸 데가 딱히 없어서 메이플스토리를 시작했습니다. 이제 모라스 코앞이네요. 12월 30일에 모라스에 갔습니다. 어쩌다 보니 받는 것보다 많이 결제하고 있지만 결제한 만큼 월급으로 돌려(?)주니 괜찮지 않을까라고 생각하고 있어요..


대회 프로그래밍

코드포스

올해는 그토록 염원하던 오렌지를 드디어 갔습니다.

2100

근데 레이팅이 딱 2100점입니다.

근데 이 어려운 걸 한 번 더 해냅니다.

+0

이 사람은 대체 뭐 하는 사람일까요? 대체 어떻게 했던 걸까요?

오렌지 수문장

그래프가 딱 2100에 걸쳐 있습니다.

오렌지가 되니까 Div 1 이외에서는 레이팅 변동이 일어나지 않습니다. 근데 Div 1은 자주 열리지도 않고, 열리는 날에는 제가 뭔가 바빠서 매번 못 치게 되더랍니다. 뭐 한마디로 게을러진 거죠. 복학할 때 적의환향하겠다던 시프트는 대체 어디로 가고? 다시 열심히 쳐야겠어요.

대회 개최

이미지
보셨나요? 저의 15 연속 검수!

UCPC 2020을 개최하고, 많은 대회에서 검수 및 출제를 했습니다.

  • 진짜 최종 구데기컵 2 – 출제, 검수

  • UCPC 2020 (전대프연 여름 대회) – 운영 총괄, 출제, 검수, 조판

  • SUAPC 2020 (신촌지역 연합 여름 대회) – 출제, 검수, 조판

  • 신촌지역 연합 캠프 2020 – 검수

  • SNUPC 2020 (서울대학교) – 검수

  • Uni-CODE 2020 (UNIST) – 검수, 조판

  • SPC 2020 (서강대학교) – 검수, 조판

알고리즘 문제 제작과 검수, 프로그래밍 대회 진행 프로세스에 대해 과도할 정도로 많은 것들을 배울 수 있었던 한 해였습니다. 특히 글을 잘 쓰는 법을 배울 수 있었어요. 기회가 되면 SUAPC/SPC 출제/검수 후기도 작성해 보고 싶습니다.

대회 참가

여러 대회에 참가했으나 올해는 다소 부진했습니다.

  • ICPC Asia-Seoul 2020 National First Round – 팀 Redshift로 출전, 5/12솔브 #36

    • 풀이를 옳게 생각했던 건 3문제나 더 있었는데.. 강의실 키보드 탓을 했습니다.

  • SCPC 2020 – Finalist, 172/1000

    • 4번 문제가 되게 풀릴 거 같이 생겼길래 3시간동안 4번 문제만 잡다가 결국 못 풀고 망했습니다. 점수를 긁읍시다 여러분.

팀 연습 때는 NxxRC 8~10솔브 밀고 다녀서 잘하겠지 싶었는데 막상 한국 예선에서 저런 성적이 나와서 당황스러웠습니다. 개인 연습 부족인 거 같네요.

…적의환향 할 수 있을까요?

스터디 진행

Sogang ICPC Team에서 연초에 아래 주제들을 다루는 스터디를 진행했습니다.


그래픽 디자인

많은 프로그래밍 대회 운영에 참가하면서, 자연스럽게도 관련 포스터를 만들게 됐습니다.


프로그래밍 대회 문제들에 들어가는 그래픽도 많이 만들었습니다.


solved.ac 공식 SNS 계정이 생기면서 정사각형 모양의 그래픽도 만들었습니다.

solved.ac 웹 디자인은 포토샵이나 일러스트를 켜서 하지 않고 CSS로 직접 하기 때문에 따로 목업 디자인 같은 건 따로 없습니다.

아쉽게도 예전처럼 개인작을 만들거나 할 여유는 없었네요.


이외에

휴학하고 회사 다니면서 아무것도 안 한 줄 알았는데 정리해 보니까 뭔가 한 게 꽤 있었네요. 건강검진에서 많이 쉬라는 소리를 들어서 내년 목표는 바쁘지 않게 한 해를 보내는 것으로 해야겠습니다.

이미지
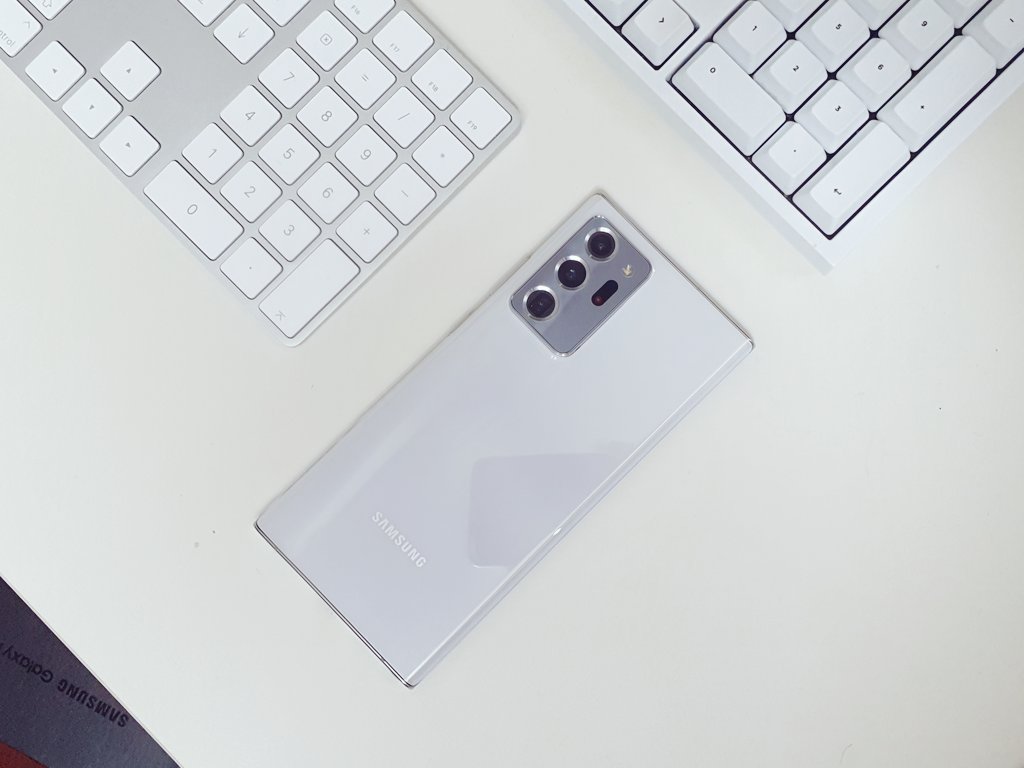
갤럭시 노트20 울트라 5G

휴대폰을 갤럭시 노트 20으로 바꿨어요. 흰색이 정말 예쁘길래 흰색으로 샀는데 잘한 선택인 거 같아요. 5G폰이지만 5G가 너무 안 터진다는 소리가 많아서 5G를 쓰지 않기 위해 자급제로 샀습니다. 근데 정작 노트에서 가장 중요한 기능이라고 할 수 있는 S펜은 자주 안 쓰게 되더라구요. 왼쪽에 달려 있어서 그런가..

라프텔

저어어엉말 오랜만에 애니메이션을 열심히 봤습니다. 넷플릭스도 열심히 봤습니다. 베스 하먼을 보고 체스 세트를 샀어요. 근데 잘 못 두는 거 같네요.

이미지
신도림역 출발열차 (특징: 신도림에서 출발함)

신도림역 출발열차의 존재를 알고 삶의 질이 올라갔어요.

이미지
츄니즘

세가의 리듬게임 ‘츄니즘’이 한국에 정식 발매되어서 휴가 쓰고 한주 내내 다녀왔어요.

이미지
서강대교에서 찍은 여의도

자전거를 유난히 많이 탔던 해였던 거 같기도 하네요. 특히 학교에서 놀거나 문제 풀다가 or 상수역 오락실에서 놀다가 서강대교 건너서 집에 따릉이 타고 자주 왔는데, 이제는 코로나 시국이 심해져서 자전거 타고 밖에 돌아다니기도 눈치 보이게 되었어요. 코로나가 없던 시절이 너무 그립네요..


솔브드 백엔드 Node.js 포팅도 마치고 싶었고, 그림도 그릴 줄 알게 되면 좋겠다 싶었고, 코드포스 레드도 가고 싶었고, 되게 하고 싶었던 게 많았어요. 다 못 이뤄서 올해 별로 한 게 없었던 줄 알았는데.. 정리해 보니까 이런 시국 속에서도 올해 되게 뭔가 많이 했었네요 😅 제가 너무 하고 싶은 게 많았나봐요. 좀 한가하게 살아도 되겠습니다. 건강검진에서도 많이 쉬라는 소리를 들었구요.

이 정도면 올해 나름 잘 보냈네요. 신년 목표도 한 해 적당히 잘 보내는 걸로 해야겠습니다. 새해 복 많이 받으세요~ 🔔