프로그래밍 문제를 출제하다 보면 가끔 실수를 다루는 문제를 출제하고 싶어질 때가 있습니다. 웬만하면 모든 걸 정수로 하면 좋겠지만 문제 상황이 그렇지 못할 경우도 존재하죠. 그러나 우리가 다루는 실수는 사실 정확히 말하면 실수가 아니기 때문에 조심해야 할 점들이 꽤나 있습니다.
이 글은 floating point 실수 연산의 오류 분석과, 이를 기반으로 프로그래밍 문제에서 좀 더 옳은 정답 데이터를 만드는 방법에 대해 소개합니다. 굳이 문제나 데이터를 만들지 않더라도 일반적으로 프로그래밍 문제에서 실수를 다루는 데에 참고하면 도움이 될 것입니다.
IEEE 754
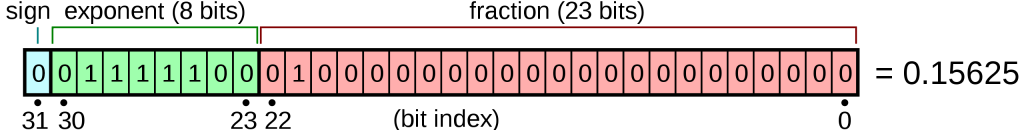
아마 float이나 double 등을 처음 배울 때 한 번쯤은 봤을 법한 그림입니다. 지금은 잊어버렸을 수도 있겠습니다만, 아무튼 컴퓨터가 실수를 그렇게 정확하게 나타내지는 못한다는 것쯤은 알고 계시리라 생각합니다.
사실 float과 double은 아무 실수나 나타낼 수 있는 것이 아니며, 분모가 인 유리수만을 나타낼 수 있습니다. 심지어 과 같은 우리가 보기에 간단해 보이는 유리수도 분모를 으로 나타낼 수 없기에, double x = 0.1을 하면 이 아니라 을 최대한 근사한 값1이 들어가게 됩니다.
양수 float 값 는 일반적으로 다음과 같이 저장됩니다2:
여기서 는 음이 아닌 정수이고, 는 소숫점 아래에 쓸 수 있는 의 이진수 소수입니다. 수의 크기에 따라 를 조절해서 보다 크거나 작은 수를 표현할 수 있습니다.
int, long long 등에 제한이 있듯이 float, double도 한정된 비트를 사용하는 만큼 제한이 있습니다. 아래 정보는 일반적인 온라인 저지 환경에서의 GCC를 가정합니다.
| 비트 | 비트 | |
| 비트 | 비트 | |
| 비트 | 비트 | |
| 비트 | 비트 |
자릿수가 제한되어 있는 만큼 이산적입니다. 예를 들어 자리만 사용할 수 있는 상황이고 , 즉 라고 한다면 과 사이의 수는 표현할 수 없게 되는 것입니다.
사실 나 보다 중요하게 봐야 할 건 의 유효숫자 수입니다. 이게 전부 진수라서 생각하기 어려울 수 있으니 로 나눠서 생각해 보면 이렇습니다.
진 자릿수 | ||
| 비트 | 자리 |
| 비트 | 자리 |
| 비트 | 자리 |
| 비트 | 자리 |
이 이후부터는 참값과 근삿값을 구분해야 할 일이 있으면 다음과 같은 표현법을 쓰도록 하겠습니다. 는 ECMAScript 스펙에서 따왔습니다.
그리고 편의를 위해 는 에 이미 더해져 있다고 생각하겠습니다.
정확도의 소실
유효숫자가 정해져 있다 보니 불가피하게 정확도의 소실이 일어납니다. 그래서 일반적으로 실수를 다루는 문제들은 절대/상대 오차 얼마 이하는 정답으로 간주합니다. 하지만 문제를 만드는 입장에서는 정해의 오차가 얼마 정도인지를 정확히 알고 있어야 참가자에게 ‘이 정도의 정확성을 갖는 풀이를 제출하십사’라고 요구할 수 있습니다. 반대로는 ‘이 정도의 정확도를 요구하려면 정해가 어느 정도로 정확해야겠구나’를 생각할 수 있겠죠.
여기서 ‘절대 오차’와 ‘상대 오차’에 대해 먼저 설명하도록 하겠습니다.
의 근삿값 가 만큼의 ‘절대 오차’를 갖고 있다는 것은 임을 의미합니다.
반면 가 만큼의 ‘상대 오차’를 갖고 있다는 것은 임을 의미합니다. 실생활에서 ‘% 정도의 차이가 발생할 수 있다’같은 표현이 상대 오차 이 발생할 수 있다는 것과 같은 표현이겠네요.
이제 자주 사용하는 연산들에서 오차가 얼마나 발생할 수 있는지 하나하나 뜯어보도록 합시다.
입력
조금 전에 참값을 어떻게 float이 다룰 수 있는 값으로 근사하는지 설명했습니다. 참값 를 유효숫자 비트의 float 값 로 나타내려고 한다면 정확히 얼마만큼의 오차가 발생할까요?
일단 라고 한다면, 의 자릿수 제한을 맞춰 주기 위해 을 최대한 가까운 자리 이진 소수로 반올림합니다. 이렇게 하면 에는 최대 만큼의 절대 오차가 발생하게 됩니다.
과 의 입장에서는 어떨까요? 앞서 언급한 것은 에서의 오차였으므로, 입장에서 생각하려면 를 곱해 줘야 합니다. 그러면 입장에서의 절대 오차는 입니다.
앞서 는 수의 크기에 따라 조정된다고 설명했습니다. 음? 입력받는 값의 스케일에 따라 결정된다구요? 그러면 오차를 절대 오차보다는 상대 오차로 나타내는 것이 괜찮은 옵션인 것 같아 보입니다.
상대 오차는 최대
이고, 이므로
가 됩니다. 따라서 반올림 오차는 상대 오차로 최대 입니다. 이를 간단하게 나타내기 위해, 부동소수점 수에서 다음 수와의 간격을 나타내는 기계 입실론machine epsilon을 도입해 표기해 봅시다. 기계 입실론은 과 같이 나타내고, 이므로 로 표현할 수 있겠습니다.
결론: 실수를 입력받으면 최대 만큼의 상대 오차가 발생합니다.
double에서 임을 생각하면 유효숫자가 자리쯤 된다고 볼 수 있습니다. 따라서 double을 입력받았다면 앞의 자리까지는 믿을 수 있다고 할 수 있겠습니다.
부호가 같은 수의 덧셈
유효숫자 세 자리 float에서, 와 를 더하는 상황을 가정해 봅시다.
그냥 더하면 이 되지만, 우리의 float은 유효숫자 개까지만을 허용하므로 부분을 날려야 합니다. 따라서 계산된 값을 다시 float에 저장하면 부분만이 남습니다.
컴퓨터는 계산 과정에서는 저장하는 float의 두 배 정도의 공간을 사용해 정확하게 계산하고 이후 반올림하기 때문에, 덧셈의 경우에도 반올림 오차 한 번만이 발생합니다. 이는 상대 오차 입니다.
부호가 같은 두 float의 덧셈에서는 만큼의 상대 오차가 발생합니다.
그러나 여기에는 함정이 있는데, 이라는 점입니다. 와 는 이미 만큼의 상대 오차를 갖고 있습니다. 따라서 와 의 상대 오차는 이미 입니다. 여기서 반올림도 수행해야 하므로, 발생할 수 있는 오차는 최대
입니다. 는 너무 작아서 무시할 수 있습니다(후술). 따라서 다시 결론을 내리면,
결론: 부호가 같은 두 실수를 입력받아 더하면 만큼의 상대 오차가 발생합니다.
여담으로 큰 차이가 나는 두 수를 더하면 더하는 것에 의미가 없어질 수도 있습니다. 예를 들어 과 을 더하는 경우 계산 결과는 이 되지만, 반올림하면 이 되어 와 같아집니다. 자체는 float으로 정확히 표현할 수 있을지 몰라도, 이상의 값과 더하면 이와 같은 현상이 나타나기 때문에 생각하지 않아도 괜찮습니다.
곱셈과 나눗셈
이번에는 와 를 곱하거나 나누는 상황을 생각해 봅시다.
반올림하면 이렇게 됩니다.
계산 과정에서의 정확도 손실은 발생하지 않으며(나눗셈의 경우 무시할 수 있을 정도로 작습니다), 반올림 오차 가 발생합니다.
이번에도 임을 고려해 봅시다. 와 의 상대 오차는 가 되고, 반올림을 수행해 로 만들면 가 됩니다. 나눗셈도 같은 방법으로 계산 가능합니다.
결론: 두 float의 곱셈/나눗셈에서는 만큼의 상대 오차가 발생합니다.
두 실수를 입력받아 곱하거나 나누면 만큼의 상대 오차가 발생합니다.
부호가 같은 수의 뺄셈
뺄셈, 혹은 부호가 다른 수의 덧셈은 위에서 언급한 덧셈과 비슷하지만 상황이 조금 다릅니다. 특히 이면서 차이가 얼마 안 나는 값을 계산하려고 하는 경우입니다.
예를 들어 에서 을 빼는 경우를 생각해 봅시다. 결과는 입니다. 이는 별 문제가 없어 보이지만, 계산 결과에서의 밑줄 친 은 에도 에도 없었던 값입니다. 이 새롭게 생긴 유효 비트 개를 그냥 믿기에는 조금 꺼림칙합니다. 다행히도 두 값이 근삿값이 아니라 참값이라면, 즉 고 라면 계산 결과는 정확하고 믿을 수 있습니다.
하지만 가 정확한 값이 아니라면, 즉 과 의 차이가 크다면 문제가 됩니다. 예를 들어 에서 를 빼는 상황을 생각해 본다면 정확한 결과는 여야 하지만, , 이므로 가 됩니다. 무려 두 배나 차이가 나네요!
조금 더 극단적인 예로 에 대해 다음과 같은 계산을 한다고 가정해 봅시다.
이 나와야 할 것처럼 보입니다. 그러나 이 반올림 오차보다 작으므로 실제로는 아래와 같이 계산됩니다.
이는 무려 %의 상대 오차입니다. 이런 현상을 재앙적인 소거catastrophic cancellation라고도 합니다.3
따라서 뺄셈을 정확하게 하고자 할 경우 비슷한 두 값의 뺄셈을 최대한 피하도록 해야 합니다. 예를 들어 앞서 언급한 의 경우, 로 계산 순서를 약간 바꾸면 조금 더 정확한 값을 얻을 수 있을 것입니다.
결론: 부호가 같은 두 실수의 뺄셈을 하는 상황은 가급적 피하는 것이 좋습니다.
덧셈, 곱셈, 나눗셈은 상대적으로 훨씬 ‘안전한’ 연산이므로 가능한 경우 덧셈, 곱셈, 나눗셈만을 사용하도록 수정합니다. 일례로 실수 값의 누적 합을 구해야 한다면 대신 펜윅 혹은 세그먼트 트리를 사용할 수 있습니다.
여담으로, 같은 부호이더라도 두 배 이상 차이가 나는 값의 뺄셈은 이하의 오차만이 발생함을 덧셈의 경우와 비슷한 방법으로 보일 수 있습니다.
뺄셈을 포기할 수 없다면
뺄셈의 오차를 다른 상황과 같이 생각할 수 없는 이유는 없는 유효숫자를 만들어야 하는 상황 때문입니다. 따라서 상대 오차를 계산하기는 어렵습니다. 하지만 절대 오차를 계산해 볼 수는 있습니다.
에서 을 빼는 연산을 생각해 봅시다.
우선 이 값들을 입력받는 과정에서 반올림 오차 가 생깁니다. 이 오차는 상대 오차이므로, 절대 오차로 바꾸면 각각 과 이 됩니다. 따라서 과 은 최대 의 절대 오차를 가집니다.
이제 을 로 근사합니다. 이 과정에서 반올림 오차 가 한 번 더 생깁니다. 의 절대 오차에 의 상대 오차가 한 번 더 생기므로, 총 절대 오차는 입니다.
앞서 언급했던 것처럼 는 에 비하면 무시할 수 있는 수준이므로, 만큼의 절대 오차가 발생한다고 할 수 있습니다.
따라서 다루는 수들의 스케일을 알고 있다면, 다행히도 발생하는 오차를 절대 오차로나마 가늠할 수 있습니다.
결론: 부호가 같은 두 실수 와 가 있을 때,
에서 를 빼면 최대 만큼의 절대 오차가 발생합니다.
정리해 보면 이렇습니다.
연산 | 부호가 같은 경우 오차 | 부호가 다른 경우 오차 |
입력/반올림 | 상대; | – |
상대; | 절대; | |
절대; | 상대; | |
상대; | 상대; | |
상대; | 상대; |
그러나 이 표에서 언급한 덧셈과 뺄셈에서의 상대 오차는 덧뺄셈 한 번에서 발생하는 오차이고, 덧셈을 계속 누적해나간다면 덧셈을 할 때마다 반올림 오차가 새로 발생하고, 이는 절대 오차로서 더해짐을 간과하면 안 됩니다. 프로그래밍 문제에서는 일반적으로 덧셈을 여러 번 하는 상황이 많기 때문에, 덧뺄셈은 아예 절대 오차로만 생각하는 편이 좋겠습니다. 이렇게 하면 부호가 같은 경우와 다른 경우에 차이가 없어지며, 다음과 같이 다시 한 번 정리할 수 있습니다.
연산 | 오차 |
입력/반올림 | 상대; |
절대; | |
절대; | |
상대; | |
상대; |
정해 코드의 오차 계산 및 문제 설계
문제에서 얼마만큼의 오차를 허용할지는 정해 코드의 최대 오차를 계산함으로서 정할 수 있습니다.
BOJ #1546 평균과 똑같은 문제를 조금 더 어렵게 세팅한다고 가정해 봅시다. 정해 코드를 이렇게 짰습니다.
double s = 0;

int n;
cin >> n;
while (n--) {
    double x;
    cin >> x;
    s += x;
}

cout << fixed << setprecision(12) << s / n << '\n';
일단 의 오차는 덧셈 번이 누적되므로 높게 잡아도 이하의 절대 오차가 생깁니다. 마지막에 나눗셈 한 번을 하므로 상대 오차 가 한 번 더 생깁니다.
그러면 총 절대 오차는 , 총 상대 오차는
가 됩니다.
허용 오차 설정하기
double로 풀리게 하고 싶다면 어떻게 해야 할까요? double에서는 이므로 넉넉하게 로 두고 계산하면, 위 코드의 절대 오차는 , 상대 오차는 가 나옵니다. 따라서 의 값에 따라 오차 허용 범위가 달라지는데, 로 설정한다면 상대 오차가 약 이 되므로 혹은 그보다 넉넉한 허용 범위를 잡으면 무리 없이 통과할 것입니다. (통상적으로 상대 오차 혹은 절대 오차 중 하나만 범위에 들어오면 맞도록 하기 때문에 그렇습니다.)
반대로 인 상황에서 float을 저격하고 싶다면 어떻게 해야 할까요? float에서는 이므로, 로 보수적이게 잡으면 상대 오차 라는 계산이 나옵니다. 따라서 허용 오차 범위를 로 잡으면 float을 사용한 코드가 통과하지 못할 가능성이 있고, 혹은 그 이하로 잡으면 float이 통과하기 어려운 문제로 세팅할 수 있을 것입니다.
위의 예시에서도 그렇듯이 float의 경우 덧셈을 번만 하는데도 혹은 그 이상의 오차가 발생하기 때문에, float 코드는 부정확한 값을 도출하기 상당히 쉽습니다. 그래서 float을 굳이 통과시켜 주려고 의도하는 상황이 아니고서야 float으로 작성한 코드는 그냥 틀렸다고 생각하고, double으로 해결하는 경우만 신경써도 충분합니다.
In Practice
그러나 문제에서 요구하는 계산이 많아지고 복잡해지면 코드마다 사칙연산을 수행하는 횟수가 천차만별일 수 있습니다. 따라서 실수 오차를 신경쓰는 게 문제가 물어보는 주요 포인트가 아닌 이상 실제 세팅할 때는 위에서 언급한 표의 모든 상수를 정도로 놓고 오차 허용 범위를 설계하게 됩니다. 앞의 상수는 계산 횟수에 비례하기 때문입니다.
연산 | 일반적으로 허용하는 오차 |
절대; | |
절대; | |
상대; | |
상대; |
굳이 으로 두는 이유는 앞서 말했듯이 상수와 계산 횟수는 비례하기 때문에, 상수가 너무 커질 정도로 계산 횟수가 많아지면 차라리 시간 초과가 나는 편이 낫기 때문입니다.
데이터 제작
특히 데이터를 제작할 때 주의해야 하는 점이 있습니다. 바로 데이터 자체에 오차가 있는 경우입니다. 데이터도 컴퓨터로 계산하는 것이기에 일반적인 방법으로 만든다면 데이터에도 그만큼의 오차가 생길 수밖에 없고, 이렇게 오차가 있는 데이터를 기준으로 채점하면 오히려 맞아야 하는 답을 틀리다고 채점하게 될 수도 있습니다. 실수를 많이 다뤄보지 않은 세터가 꽤 흔하게 하는 실수입니다.
이를 방지할 수 있는 방법은 여러 가지가 있는데, 몇 가지를 소개하자면:
long double,__float128, PythonDecimal, JavaBigDecimal등double보다 훨씬 정확한 자료형을 통해 계산합니다.가능한 경우 모든 계산을 정수로 수행합니다. 분모와 분자를 관리하는 분수 구조체를 만들거나, Python
Fraction을 사용하는 것도 고려해 볼 수 있습니다.
정해 소스의 오차가 최대 얼마인지를 계산하는 것의 중요성을 강조하고 싶습니다. 개인적으로 double로 풀리게 하고 싶다면 데이터는 적어도 최대 만큼의 오차만을 갖도록 만드는 것을 권장합니다.
여담
사칙연산 이외의 함수들의 오차는 어떻게 구하나요?
IEEE 754는 사실 아래의 연산들에 대해 가장 가까운 실수를 계산할 수 있도록 하고 있습니다4. 의외로 제곱근이 들어가 있습니다.
사칙연산
제곱근
단일 곱셈 누산
나머지 연산
최대 및 최솟값
C는 이를 따라서, sqrt와 fmod는 반올림 오차, 즉 상대 오차 만을 가지도록 합니다. 단, 이는 인자들이 참값임을 가정한 오차임에 주의해야 합니다.
제곱근을 제외하고, GNU C에서 실수와 관련된 함수들의 구현과 오류의 대략적인 양은 문서에 명시되어 있습니다. 문서에서 명시된 ULPunit in the last place는 이 글에서 언급한 기계 입실론과 같은 단위인데, 상대 오차입니다.
보통 채점 환경으로 주로 사용되는 x86_64에서의 주요 함수의 오차는 다음과 같습니다. 모두 계산 결과에 대한 상대 오차이므로, 입력값의 오차를 따로 고려해 줘야 함에 유의합니다.
sin,cos,tan,asin,acos,atan:pow,exp,expm1,log,log1p:hypot:sinh,cosh,tanh,asinh,acosh,atanh:cbrt:
일부 함수들은 정의역이 제한되어 있으므로(예를 들어 acos는 과 사이의 입력만 허용합니다) 계산 과정에서 실수로 정의역을 벗어나는 값을 넣지 않도록 주의해야 합니다. 또한 아래 함수들은 특정 범위의 입출력을 피하거나, 입력 범위에 각별히 주의하는 것을 요합니다.
log: 출력값이 에 가까울 것으로 예상하는 경우.이 필요한 상황이라면 의 값을 조금 더 정확히 입력할 수 있는
log1p함수를 사용합니다: .가 작다면, 을 계산하는 데에서 이미 정확도의 손실이 일어납니다.
exp,pow: 출력값이 에 가까울 것으로 예상되는 경우.의 정확한 값이 필요한 상황이라면 마찬가지로
expm1함수를 사용합니다: .
fmod: 나눠지는 값이 나누는 값보다 너무 큰 경우.인자가 참값이 아니라 반올림된 값일 경우 뺄셈과 비슷하게 재앙적 소거가 쉽게 발생할 수 있습니다.
여담으로, tan 함수의 경우 왼쪽에서는 로 발산하고 오른쪽에서는 로 발산하지만, 어떤 부동소수점 값도 를 정확히 표현할 수 없어서 우려하는 오류가 발생하지 않습니다.
일부 연산은 CPU가 직접 지원하고, CPU의 구현에 따라 오차가 다르게 발생하는 경우가 존재합니다. 예를 들어 exp10 함수는 CPU가 10의 제곱 연산을 지원한다면 코드로 계산하려고 하지 않고 하드웨어로 __builtin_exp10을 통해 더 빠르게 계산하려고 할 것입니다.
glibc 소스에서도 상세 구현을 확인하고 오차를 가늠할 수 있습니다.
다른 방식으로 오차를 구하는 글도 있던데 여기서는 왜 이렇게 구하나요?
아마 의 오차 는 라고 설명하는 글을 보셨을지도 모르겠습니다. 이는 물리학 등에서 와 가 여러 번의 측정을 통해 얻어낸 평균값이고, 오차가 확률분포(특히 정규분포)에서 추출될 것이라고 가정할 수 있을 때 사용하는 방법입니다. 즉, 우리가 다루는 오차와는 다른 성격의 오차입니다. 여기에서는 수치해석적 관점에서의 오차 전파를 다루고 있습니다.
마무리하면서
부동소수점 오차는 참 다루기 힘든 주제입니다. 이 글이 부동소수점 오차에 대한 막연한 가늠과 추측을 해소하고 좀 더 좋은 문제들을 만드는 데 기여해, 제가 백준에서 맞왜틀을 덜 당할 수 있기를 희망합니다.
이 글 작성에 도움을 주신 김영현kipa00님과 김준원junie님께 감사의 말씀을 전합니다.
각주
double의 경우 은 정확히입니다. ↑
, , NaN, 그리고 인 경우는 예외입니다. ↑
반면 두 값이 참값인 경우에서 일어나는 현상은 온화한 소거benign cancellation라고 합니다. ↑
https://en.wikipedia.org/wiki/IEEE_754#Required_operations ↑
(23/7/19) 사칙연산 이외 함수들에 대한 설명을 추가했습니다. kiwiyou님께 감사의 말씀을 드립니다.
Comments
No comments yet.