자동차, 휴대폰, 이제는 LLM입니다. 세상을 완전히 바꿔놓은 발명품들이라고 하고 싶습니다. 그러나 LLM은 다른 어떤 것보다도 세상을 크게 바꿔놓을 것 같아 보입니다.
LLM은 글이 주어지면 그 다음에 올 단어 중 가장 적절한 걸 골라 주는 기계라서 태생적으로 한계가 명확할 것이라고 생각했는데, 충분히 많은 트레이닝 자료를 먹이면 대부분의 알고리즘 문제는 이런 방법으로도 풀 수 있는가 봅니다. 원주율 파이(π)의 번째 자리를 구하는 알고리즘 같은 게 있겠지만 그냥 다 외워버리면 좀 작은 에 대해서는 그런 알고리즘을 안 써도 되는 거랄까요.
저 개인적으로도 2025년까지만 해도 AI에 의존해서 프로덕트를 만든다는 생각 자체를 해보지 못했던 것 같은데요, 이제는 코드를 직접 짜는 일이 1년만에 확 줄어들어 버린 것 같습니다. 이 대단한 물건이 혹여나 우리 직업을 뺏지는 않을지 걱정이 많은 것 같습니다. 그래서 LLM과 관해 생각나는 것들을 두서 없이 정리해 보기로 했습니다.
레버리지
주식시장에서 레버리지란 쉽게 말하면 특정 주식을 N배로 따라가는 무언가를 의미합니다. 예를 들어 코스피가 오늘 4% 올랐다면, 코스피 2배 레버리지는 오늘 8% 오르는 상품입니다.
LLM을 비유하기 이만큼 좋은 게 없어 보입니다. 저는 LLM이 개인의 능력에 레버리지를 걸어 준다고 생각합니다. 같은 LLM 모델을 쓰더라도 쓰는 사람에 따라 다른 퀄리티의 결과가 나오는 것은 잘 아실 것 같습니다.
예를 들어 웹사이트를 하나 디자인하고 싶다고 합시다. 일반적으로 이런 결과물을 마주하게 되겠습니다.
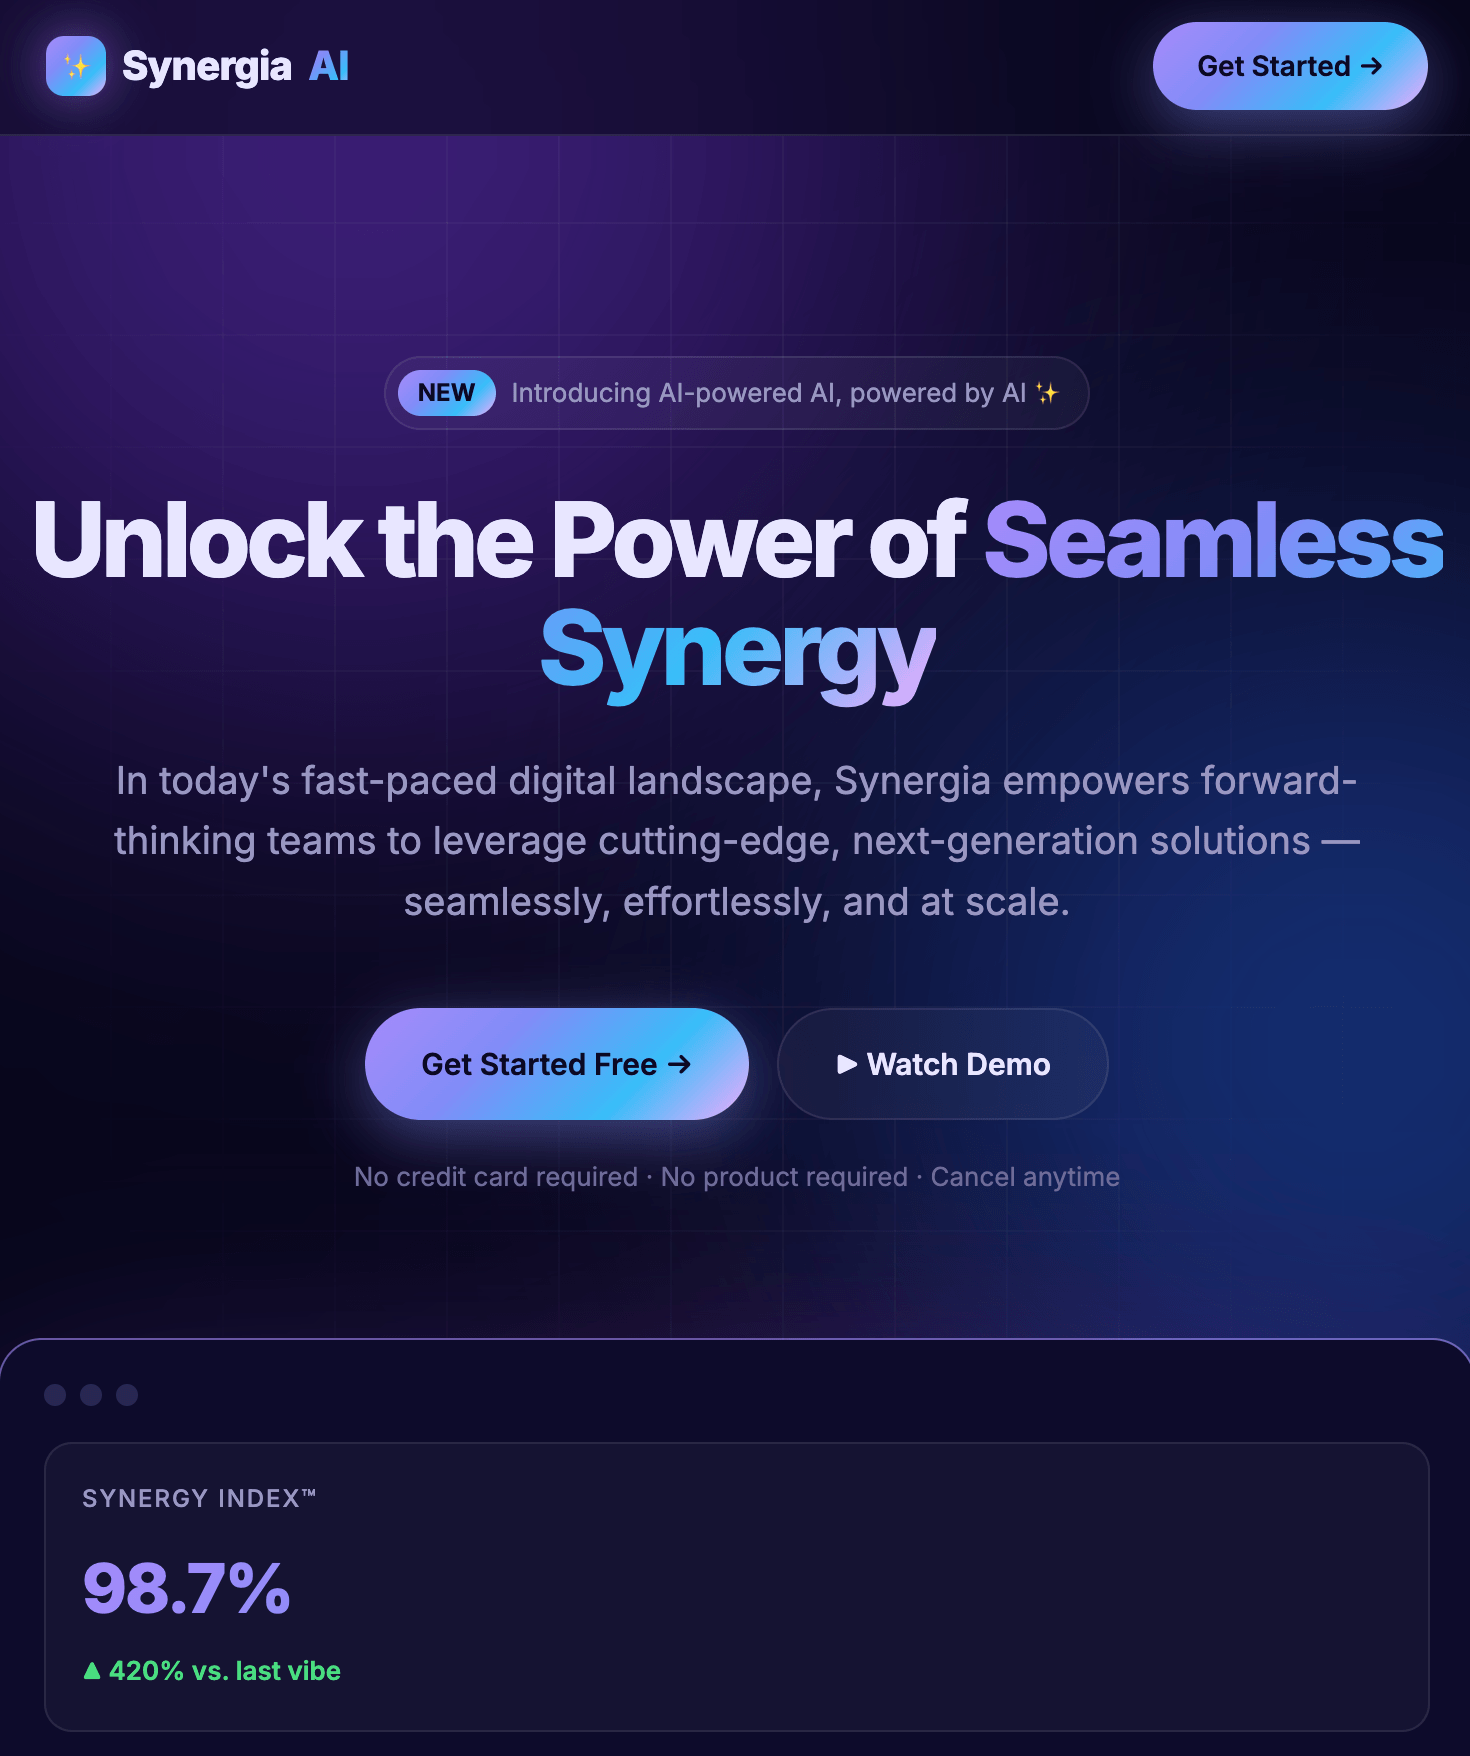
화려하긴 한데, 너무 ‘AI 같아’ 보입니다. 뭔가 정성을 들였다는 느낌이 덜하지 않나요? 소위 ‘AI 슬롭’이라고 불리는 디자인입니다.
모객을 하고 싶어하는 프로덕트를 이렇게 디자인해 출시했다면 좀 아쉽습니다. 가장 큰 문제는 사람들은 이런 디자인을 ‘성의 있다’고 생각하지 않을 것이라는 점에 있고, 아마 누군가 이걸 이 상태 그대로 출시했다면 앞의 사실 자체를 모르고 있었을 것입니다. 디자인을 해 보지 않았기 때문에 나쁜 디자인을 했을 때의 피드백을 들어본 적이 없을 것이고, 당연히 디자인을 해 본 사람에 비해 ‘좋은 디자인’에 대한 감각도 훨씬 적을 것입니다. 이는 같은 LLM을 쓰더라도 결과물이 달라지는 이유 중 하나가 됩니다.
사실 많은 AI 슬롭들에 대해서 드는 생각인데요, UI 프레임워크라도 대충 조합해서 쓰는 게 오히려 더 보기 좋은 결과를 만들었을 수도 있었을 것 같습니다. 레버리지는 음의 방향으로도 작용하니까요…
개인이 살아오면서 또는 일을 하면서 얻은 경험과 맥락은 LLM에게 기본 탑재되어 있지 않은 엄청난 자산입니다. 제가 개인적으로 LLM을 사용해서 업무를 하던 경험으로는 사람이 LLM보다 ‘맥락’이라는 것을 효과적으로 다룰 수 있다고 느꼈고, 개개인이 갖고 있는 업무에 대한 ‘맥락’이 같은 모델을 쓰더라도 결과물에 차이를 만드는 결정적 요인이라고 생각하게 되었습니다.
여기서 ‘맥락’은 여러 가지가 될 수 있는데요, 만들고 있는 프로젝트와 직접적인 관련이 있는 지식들(기획서라던가)이 될 수도 있고, 프로젝트가 속해 있는 필드에서의 지식들, 쓸모없어 보이는 잡학지식들, 살면서 경험하고 느낀 것들 등등이 전부 해당됩니다.
개인적인 경험
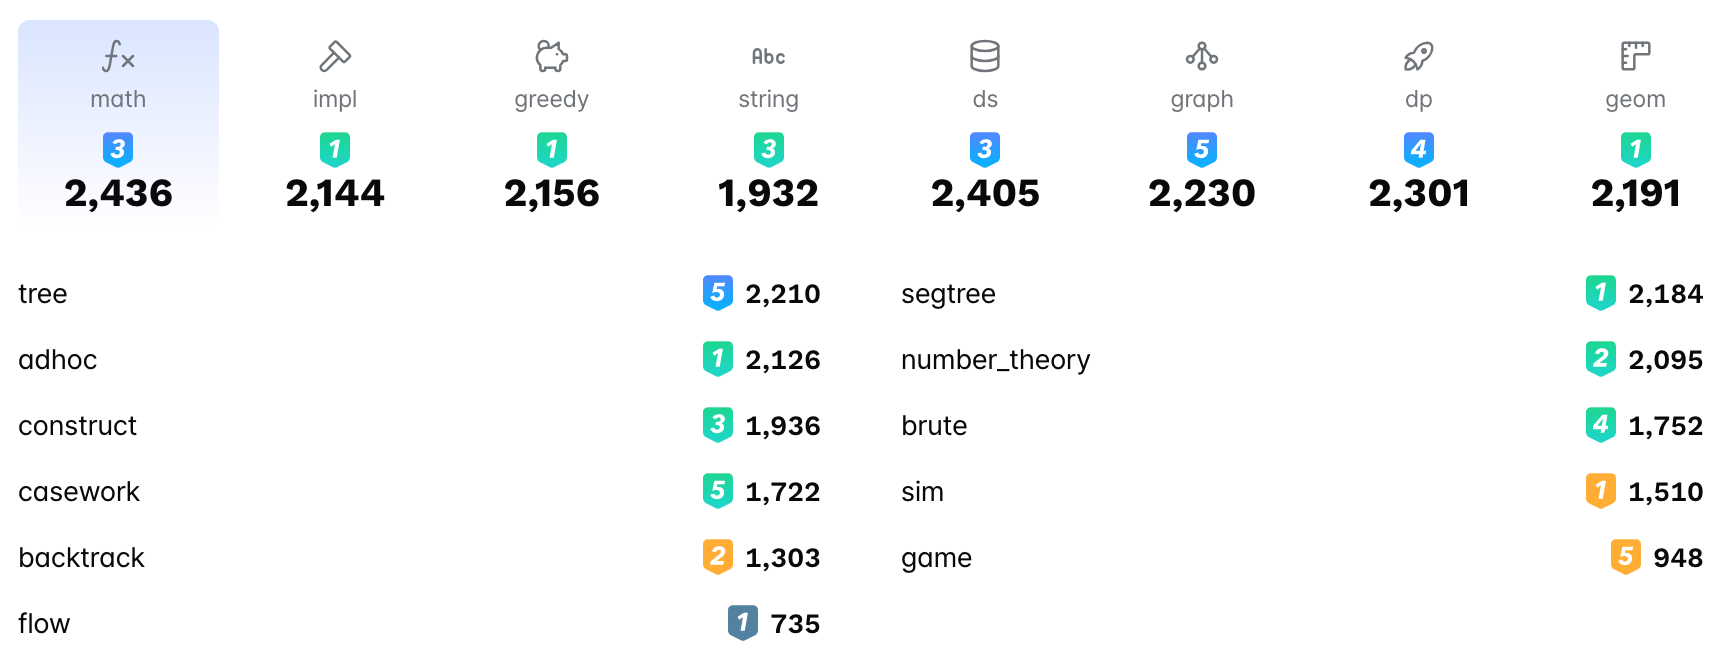
최근 솔브드가 태그 레이팅을 최적화한 일화를 소개해 보고 싶습니다.
솔브드는 간단히 말해 문제은행인데요, 각 문제에는 ‘난이도’와 유형을 나타내는 ‘태그’들이 붙어 있습니다. 이 값들은 문제를 해결한 사람들이 리뷰와 같은 형식으로 기여하는 것이기 때문에 난이도와 태그들은 시간에 따라 변할 수 있습니다.
‘태그 레이팅’은 어떤 유저가 어떤 유형을 얼마나 잘하는지를 나타내기 위한 지표입니다. 어떻게 계산하느냐면, 어떤 태그 안에서 어떤 유저가 해결한 가장 어려운 50개의 문제들을 골라서 합산합니다. 기존에는 이 값을 계산하기 위해 유저가 문제를 해결할 때마다 해결한 모든 문제와 그 태그 정보들을 가져와 레이팅을 열심히 계산했습니다. 문제를 가장 많이 푼 유저는 1만 7천여개의 문제를 해결했기 때문에 사이트를 느리게 하는 주범이었습니다.
이번에 사이트를 새로 구현하면서 LLM에게 태그 레이팅의 최적화를 부탁했습니다. 위의 상황을 알려주고, 추가로 “난이도는 0부터 30까지의 정수 값이고, 태그는 200여개가 있습니다. 이 문제를 알고리즘 문제처럼 생각해서 최적화해 주세요.”라는 지시를 했습니다. 유저별로 태그별로 난이도별 몇 문제를 풀었는지 캐싱하는 삼차원 배열 비슷한 캐시를 만들라고 하더군요.
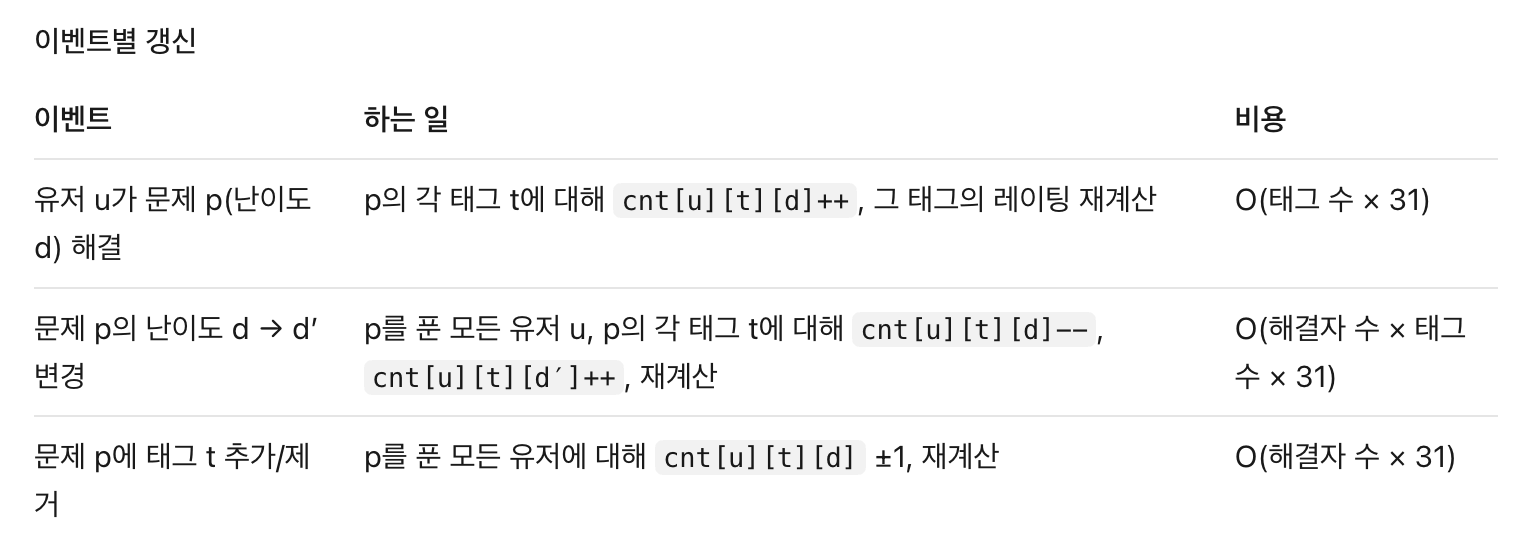
놀랍게도 기존에 운용하던 캐시 테이블과 똑같은 구조였고 별 도움이 되지 않았습니다. 애초에 유저 × 태그 × 난이도는 단순히 계산해 봐도 (12억)이고, 이걸 SQL 테이블로 만들면 쿼리 자체가 매우 비싸지겠죠. 태그 계산이 느리던 이유 그 자체였습니다.
실제로는 500문제 이상의 문제가 있는 태그들의 레이팅만 보여줬기 때문에 태그 개수는 이것의 가량이었는데요, 여전히 작은 수는 아니었고, sparse하게 해도 버전업 시점에는 4천7백만개 레코드가 있었으며, 500문제 이상인 태그의 목록 자체도 바뀔 수 있는 목록이었기 때문에 고려할 것이 늘었습니다.
저는 솔브드를 누구보다 잘 알고 있는 사람이기 때문에 솔브드의 여러 상황을 고려하여 빠르게 타협안을 찾을 수 있었습니다.
저는 어차피 ①개인이 푼 문제 수는 많아봐야 17,000문제이기 때문에, 버킷 하나에 2바이트를 준다면 65,535까지 저장할 수 있으므로 태그 하나당 64바이트 안에 어떤 난이도를 몇 문제 해결했는지를 캐싱할 수 있게 된다는 사실을 계산해낼 수 있었습니다.
또 저는 ②‘사칙연산’ 같은 태그의 레이팅이 의미가 크지 않고, ‘그래프 이론’ 레이팅이 있는데 ‘BFS’와 ‘DFS’의 레이팅을 따로 매기는 건 다소 불필요하다는 것, 즉 현재 태그 레이팅을 제공하는 태그 중 일부는 큰 의미가 없다는 것을 알고 있었습니다.
그래서 만약 제가 태그 레이팅을 계산해 주는 태그들을 몇 개만 직접 골라 놓는다면, 그리고 그게 32개 이하라면, 사람 한 명 당 2KiB(=64B×32) 안에 이 ③20만명 기준 391MiB는 솔브드 Redis 용량에 여유롭게 들어갈 수 있는 정도라는 계산이 나왔고,
문제 × 태그 테이블도 비트마스킹해서 Redis에서 다뤄버리면 DB에서 JOIN을 할 필요 없이 엄청나게 빠른 속도로 유저 × 태그 × 난이도별 카운팅을 할 수 있다는 결론까지 낼 수 있었습니다.
이 최적화로 결과적으로 솔브드는 현재 문제 해결 시 태그 레이팅 계산을 ~600 ms에서 ~70 µs로 8천 배쯤 개선할 수 있었으며, 이전에는 하지 못했던 문제 난이도 및 태그 변경 시에 유저 태그 레이팅 실시간 변경도 가능해지게 되었습니다.
볼드 처리한 부분을 AI가 찾아내지 못할 것이라고 생각하지는 않습니다. 시간을 들이면 충분히 분석할 수 있을 것 같아 보입니다. 하지만 배경 지식이 없는 상황에서 저 사실들을 알아내고 조합해서 결론을 내는 건 그렇지 않을 때보다 시간(그리고 토큰 사용량)이 아주 많이 걸렸을 것이라고 생각합니다. AI는 모든 걸 해줄 수 있지만 시간과 토큰은 유한하고, 여전히 개인의 경험은 이런 방법으로 빛을 발하고 있다고 생각합니다.
물론 이 해결책을 제시했을 때 모든 구현을 해 준 것은 LLM이었습니다. 엄청 빠르게, 그리고 제대로 구현해 줘서 많이 놀랐습니다. LLM이 ICPC 월드 파이널 문제를 올 솔브하고 인간 1등 팀을 이긴 게 벌써 작년이니 이미 플랜이 제대로 세워져 있는 구현에 대해서는 이제는 별 실수를 하지 않고 잘 구현한다고 믿을 만한 것 같습니다.
AI 활용 역량
이렇게 큰 시너지를 만들어주는 LLM, 잘 쓰는 것은 당연히 중요하겠지요. LLM이 뭘 잘 해 주고 뭘 못 하는지, 어떻게 해야 LLM이 일을 더 잘할 수 있게 할 수 있는지는 알아둘 필요가 있는 것 같습니다. LLM을 써 보면서 알아가는 것이 가장 효과적이라고 생각합니다. 무턱대고 내가 만들 수 없던 걸 만들어 보라고도 하고, MCP도 연결해서 알아서 메일로 들어온 피드백을 해결해 보라고도 하고, 이 친구가 어떤 큰 실수를 해서 내 DB가 날아갔나(…)도 한 번 알아보고, 등등입니다. 이게 어떤 도구인지 알아갈 필요가 있습니다.
제가 알아낸 것들 중 하나는 LLM은 시각적인 것을 잘 못 다룬다는 점입니다. 디자인을 할 때 특히 그런데, 어떤 이미지를 주고 똑같이 구현해 달라고 할 때 더 두드러집니다. 이미지를 열심히 텍스트로 설명한 뒤 그 텍스트만을 읽고 구현을 하는 것처럼 보였습니다. 당연한 일이지요. 아마도 LLM이 그럴듯해 보이는 UI를 만드는 것은 실제로 UI를 시각적으로 보고 심미적으로 판단할 능력이 있는 건 아닌 것 같고, 주입식 교육을 잘 받아서라고 느꼈습니다. 그래서 LLM은 틀에 박히지 않은 디자인을 해야 될 때는 쓰지 않고 있습니다.
반면 사람들이 많이 사용하는 여러 기술들의 도메인 지식에는 깊은 이해를 갖고 있는 것처럼 보여서, 제가 새로운 도메인에 입문하는 것이 이전보다 훨씬 쉬워졌습니다. 예를 들어 LLM의 도움을 받아 Terraform을 바로 업무에 도입할 수 있었고, 그 과정에서 제가 여태까지 인프라를 얼마나 잘못 관리하고 있었는지도 깨달을 수 있었습니다.
다만 세상이 돌아가는 걸 보고 있자면 일각에서는 AI 활용 역량 자체만이 너무 강조되는 느낌도 받게 됩니다. 다시 언급하자면 AI가 모든 걸 해주는 도구는 맞지만 그 속도와 비용은 쓰는 사람마다 다르고 시간과 토큰은 한정되어 있습니다. 동일한 시간 안에 더 적은 비용으로 더 대단한 결과를 낼 수 있는 사람이 선호되는 것은 당연합니다. ‘AI를 얼마나 잘 쓰는가’ 하나만으로 사람을 뽑는 건 수익률도 보지 않고 2배 레버리지 투자자 대신 3배 레버리지 투자자를 뽑겠다는 것만큼이나 황당한 결정이라고 생각합니다.
코딩 테스트
그래서 기업들은 왜 채용문들 꽁꽁 잠그고 있느냐 하면 지금은 ‘좋은 지원자’가 누구인지 기업들조차도 판단하기 쉽지 않기 때문이라고 생각합니다.
요즘은 코딩 테스트 같은 걸 많이 안 하게 되었습니다. 기업 입장에서 지원자를 전부 면접을 보게 되면 실무자들이 일을 할 수가 없으니 최소한의 실력이 보장되어 있는 지원자들만을 가려내기 위해 있던 것이 코딩 테스트였습니다. 비용 절감을 위한 것이죠. 그러나 이제는 컴퓨터 화면을 녹화하고, 카메라로 손이 보이게 컴퓨터 화면을 찍고, 등등을 하는 데 들어가는 비용이 너무 커져 버렸습니다. 그리고 어차피 LLM이 모든 문제를 풀어주는데 이런 지식을 묻는 게 의미가 있느냐는 의문도 코딩 테스트를 점점 하지 않게 되는 계기 중 하나가 되었습니다.
그렇다고 모든 지원자를 면접으로 데려올 수 있는 것은 아닙니다. 어떤 방법으로든 스크리닝을 하긴 해야 할 텐데… LLM이 생긴 지금은 어떤 유형의 사람들이 퍼포먼스를 잘 내는지 판단하기가 애매해졌습니다. 이제는 개인의 역량을 AI 활용 능력과 곱해서 평가해야 될 텐데, 그러면 시험에서 AI를 활용할 수 있게 해 줘야 할 것 같습니다. 지금은 갈팡질팡하지만 결국 그런 방향으로 수렴하리라 생각합니다. 아니면 아예 대회장을 대관해서 현장에서 코딩 테스트를 치게 하는 것도 방법일까 하고 생각해 봤는데 그렇게 현실적이지는 않은 것 같습니다.
지원자 입장에서는 업무 분야와 관한 경험을 쌓는 게 가장 중요하다는 사실은 앞으로도 변함이 없지 않을까요? 저는 앞으로도 취업을 위해서라면 개인/팀 프로젝트 경험을 많이 쌓으시라고 조언할 것 같습니다. LLM 많이 쓰시고요, 서버도 터뜨려 보고 결과물을 게시해서 피드백도 받아 보시고요, 점점 같은 일을 빠르게 그리고 잘 할 수 있는 방법을 배워나갈 수 있게 될 것이라고 생각합니다.
의외로 (코딩 테스트 준비가 아닌) 취미로써의 알고리즘 문제해결 공부는 같은 맥락에서 개인의 성장이라는 관점에서 여전히 의미를 갖는다고 생각합니다. 자료 구조나 알고리즘 자체를 배우는 게 중요하다기보다는 문제해결력을 기르는 부분이 더 의미가 있다고 생각하고요. 취업만을 위해서라면 가성비 있는 트레이닝 방법인지는 잘 모르겠기는 합니다.
기타 잡다한 생각들
LLM 연구와 사용이 기후 위기를 가속시킨다는 주장이 있습니다. 당장은 맞는 말인 것 같은데 개인적으로는 시간이 흐를수록 LLM이 과학 연구에 충분히 기여해서 모든 것을 상쇄해 주지 않을까 하는 다소 낙관적인 생각이 있습니다.
이미지 생성 AI는 그렇지 않고 인간사에 별 도움이 되지 않을 것 같습니다.
프로그래밍 문제도 옛날에는 사람만이 풀 수 있는 영역이 있을 것이라고 생각했는데 요즘은 잘 풀어 주는 걸 보면, 디자인도 아직 충분한 주입식 교육이 일어나지 않아서 잘 못하는 것뿐인 것이 아닐지 하고 생각하고 있습니다. 하여간 아직은 잘 못 하는 건 사실입니다.
LLM에 의한 취약점 분석과 해킹이 갈수록 빈번해지고 있는데, 그냥 여태까지 인간들이 코드를 허접하게 짰던 게 아닐까 하고 생각하고 있습니다. AI 슬롭만큼이나 휴먼 슬롭도 만만찮을 것 같은데요…
무서운 시기이지만 곧 지나가지 않을까요?
제 사이트를 제가 해킹해 보고 싶은데 Claude가 이걸 할 수 있게 해 주지 않고 있어서, 로컬 LLM 모델을 굴릴 수 있는 컴퓨터를 사야 하나 고민하고 있습니다.
별개로 LLM은 원래 글을 써 주는 AI인데 재밌게도 평소에 글을 쓸 때는 LLM을 잘 안 쓰게 됩니다. 이 글도 전부 수공업으로 작성했습니다. 다만 이 글을 영어로 읽고 계시다면 번역은 LLM이 해 줬기 때문에 뭐 다소 아쉬운 일입니다.
댓글
아직 댓글이 없습니다.